#1 google, services, indexation, contenu, sitemap
Page connue de Google depuis plusieurs mois – Détectée, non indexée
Bonjour,
Je cherche à comprendre un problème d’indexation assez étrange sur mon site MaVitrineDuWeb :
https://mavitrineduweb.fr/
La page concernée est :
https://mavitrineduweb.fr/services.html
Cette page existe depuis le 12 juin 2026 et, depuis sa création, elle n’a à ma connaissance jamais été réellement explorée par Google.
Dans Search Console elle est toujours classée :
**« Détectée, actuellement non indexée »**
et surtout :
**Dernière exploration : Sans objet**
C’est ce dernier point qui m’étonne le plus. Google connaît donc l’URL, mais semble ne jamais avoir effectué de crawl normal de la page.
### Ce que donne le test en direct
Si je fais dans Search Console :
Inspection de l’URL → Tester l’URL active
Google répond :
- Google a accès à cette URL
- La page peut être indexée
J’ai également demandé plusieurs fois l’indexation au cours des derniers mois. La demande est bien acceptée et placée dans la file d’exploration prioritaire, mais cela n’a jamais abouti à une exploration visible dans le rapport.
Je sais qu’il ne sert à rien de répéter continuellement les demandes d’indexation, donc je ne le fais plus.
### La page elle-même
La page est accessible normalement dans un navigateur :
https://mavitrineduweb.fr/services.html
Elle contient du vrai contenu texte directement dans le HTML : présentation des services, site vitrine, e-commerce, blog, développement sur mesure, SEO, déroulement d’un projet, etc.
Le H1 actuel est :
**Création de sites web professionnels à La Rochelle**
La canonical est :
https://mavitrineduweb.fr/services.html
et j’ai bien :
`<meta name="robots" content="index, follow">`
Le test en direct de Search Console confirme d’ailleurs qu’il ne détecte aucun blocage d’indexation.
### Sitemap
La page est présente dans :
https://mavitrineduweb.fr/sitemap.xml
J’ai également revu la gestion des `lastmod`.
Au départ, j’avais fait l’erreur classique de mettre `new Date()` comme `lastmod`, ce qui faisait croire que les pages étaient modifiées à chaque génération du sitemap.
J’ai supprimé ce comportement et mis en place quelque chose de plus propre.
Au démarrage de l’application Node, une empreinte SHA-256 est calculée à partir des fichiers HTML/CSS concernés. Elle est comparée à l’empreinte précédente stockée dans un petit fichier JSON sur le Persistent Disk Render.
Le `lastmod` ne change donc que si le contenu des fichiers suivis a réellement changé.
Google a bien relu le sitemap depuis la mise en place de ce système.
### Liens internes
J’ai aussi renforcé le maillage interne vers `services.html`.
La page est liée depuis :
- la navigation principale ;
- la page d’accueil ;
- la page Tarifs ;
- le blog ;
- différents pieds de page.
J’ai également fait un test supplémentaire.
J’ai publié un nouvel article de blog le 9 octobre :
https://mavitrineduweb.fr/blog/post/creer-son-site-e-commerce-soi-meme-ou-le-confier-a-un-developpeur-combien-ca-coute-vraiment-partie-2
Dans cet article j’ai ajouté un lien contextuel avec une ancre descriptive vers la page Services.
Google a exploré cet article le jour même de sa publication.
Malgré cela, plus de deux semaines après, `services.html` est toujours à :
**Dernière exploration : Sans objet**
C’est ce point qui me fait penser que le problème ne vient plus simplement de la découverte de l’URL.
### Comparaison avec une page qui fonctionne
J’ai ensuite comparé `services.html` à :
https://mavitrineduweb.fr/tarifs.html
La page Tarifs est correctement indexée et Google l’a encore explorée le 23 octobre.
Les deux pages passent pourtant par exactement la même infrastructure :
Render Starter → Cloudflare → Express.
J’ai comparé leurs réponses HTTP dans Chrome DevTools.
Pour les deux j’obtiens notamment :
`Cache-Control: public, max-age=0`
`Cf-Cache-Status: DYNAMIC`
`Content-Type: text/html; charset=UTF-8`
`Server: cloudflare`
`X-Powered-By: Express`
`X-Render-Origin-Server: Render`
`Vary: Accept-Encoding`
Pas de `X-Robots-Tag` sur l’une ou l’autre.
Le `Last-Modified` est également cohérent et je n’ai pas trouvé de différence particulière dans les headers qui pourrait expliquer pourquoi l’une est explorée et pas l’autre.
### Cookie connect.sid
Une autre piste était le cookie de session Express.
Mon application utilise encore `express-session` avec `saveUninitialized: true`.
Les pages statiques peuvent donc recevoir un `connect.sid`.
J’ai comparé Services et Tarifs en navigation privée dans DevTools.
Les deux ont exactement le même comportement avec `connect.sid`.
Comme Tarifs est correctement explorée et indexée, je ne vois pas comment ce cookie pourrait expliquer à lui seul le problème de Services.
Je prévois quand même de nettoyer ce fonctionnement plus tard, car je n’ai pas réellement besoin d’une session sur des pages statiques publiques.
### Cloudflare / Render
Le site n’est pas sur une instance Render Free.
Le service est en **Starter**, donc il n’y a pas de problème de mise en veille de l’instance gratuite.
Je n’ai pas non plus de configuration Cloudflare personnelle avec un Bot Fight Mode que j’aurais activé moi-même. Le `server: cloudflare` semble venir de l’infrastructure utilisée par Render.
De toute façon, Tarifs passe exactement par la même infrastructure et est explorée normalement.
### Situation actuelle dans Search Console
Aujourd’hui j’ai 8 URL indexées.
Les autres URL non indexées sont explicables :
`/index.html` est classée comme **« Autre page avec balise canonique correcte »**, puisque la canonical est `/`.
Une ancienne URL de blog utilisant l’ID MongoDB est classée **« Page avec redirection »**, ce qui est normal puisqu’elle redirige vers la nouvelle URL avec slug.
Le seul cas qui me pose réellement problème reste donc :
https://mavitrineduweb.fr/services.html
avec :
**Détectée, actuellement non indexée**
et :
**Dernière exploration : Sans objet**
La validation Search Console du problème, commencée en juillet, est même passée à **« Réussi » le 17 octobre**, mais la page Services apparaît toujours comme seule URL concernée dans le rapport actuel.
### Une dernière piste que je regarde
Il y a un certain chevauchement sémantique entre la page d’accueil et Services.
La page d’accueil présente déjà rapidement les services proposés :
https://mavitrineduweb.fr/
alors que `services.html` les développe beaucoup plus en détail.
La page Services contient réellement du contenu supplémentaire, donc je ne pense pas qu’il s’agisse d’un simple duplicata.
Son `<title>` actuel est toutefois :
**Création de site vitrine à La Rochelle | MaVitrineDuWeb**
alors que son contenu couvre beaucoup plus largement l’ensemble des services web.
Je vais probablement clarifier ce positionnement, par exemple avec un title davantage orienté « Services de création web à La Rochelle ».
Mais même s’il y avait un problème de positionnement ou de similarité sémantique, ce qui me surprend est toujours le même point : pourquoi Google ne l’explore-t-il même pas ?
### Ma question
À ce stade, qu’est-ce qui pourrait encore expliquer qu’une URL :
- existe depuis plus de quatre mois ;
- soit présente dans le sitemap ;
- possède une canonical vers elle-même ;
- soit en `index, follow` ;
- soit liée depuis plusieurs pages internes ;
- possède même un lien contextuel depuis un article que Google a exploré ;
- réponde normalement en HTTP ;
- soit déclarée accessible et indexable par le test en direct de Search Console ;
mais reste malgré tout avec :
**Dernière exploration : Sans objet**
pendant plusieurs mois ?
Je suis preneur de toute piste, même si cela implique de reprendre quelque chose que j’ai déjà testé. À ce stade je préfère vérifier méthodiquement plutôt que continuer à modifier des éléments au hasard.
Si vous trouvez, vous êtes fortiche !
Merci d’avance à ceux qui auront une idée.
Nous devons apprendre à vivre ensemble comme des frères, sinon nous allons mourir, tous ensemble, comme des idiots.
Hors ligne
#2 crawl, maillage, trafic
Re : Page connue de Google depuis plusieurs mois – Détectée, non indexée
Salut @karlito,
J'ai analysé ton site (plus précisement cette page dont tu parle) avec un outil de crawl perf seo et effectivement globalement la page à l'air correcte
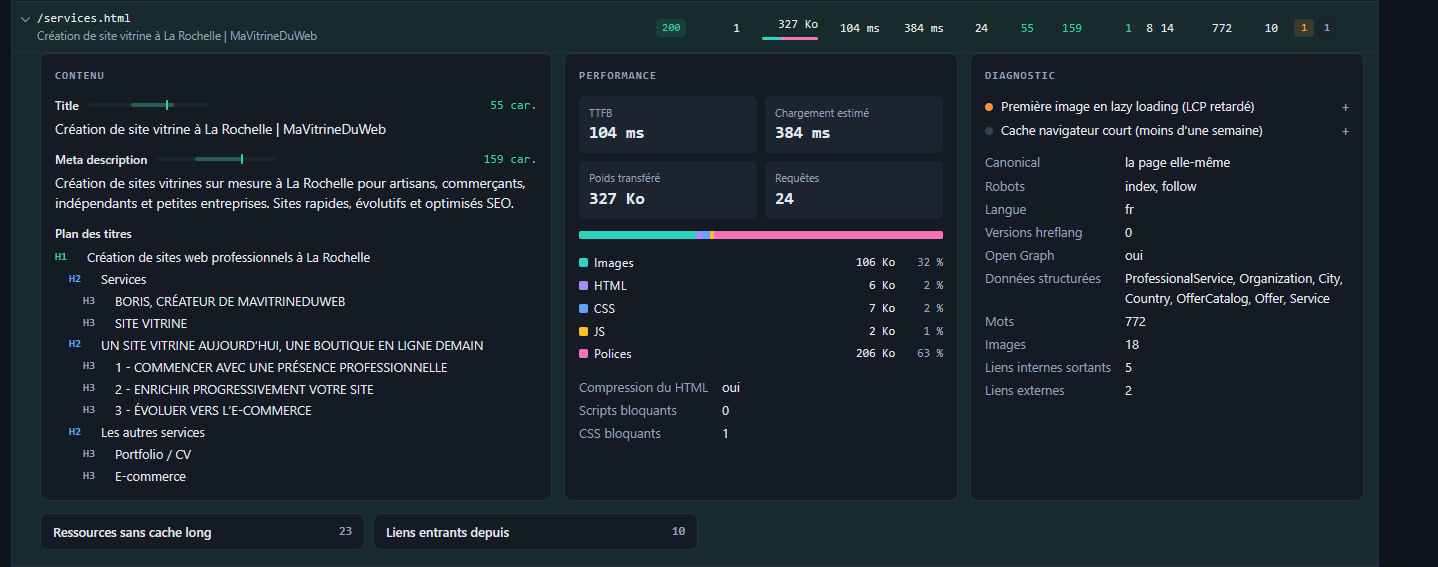
Ce que je peux suggérer :
- Vérifier qu'une autre page ne la canibalise pas
- Améliorer ton maillage interne vers cette page
- Ajouter des baclinks vers la page (depuis des sites qui indexent fortement et sont très crawlés)
- Générer des signaux vers la page (email, social, visites trafic)
Par contre ton message semble généré avec l'IA et est un peu long, je te demanderai de faire court et d'écrire directement ca sera plus simple pour aller droit au but et ne pas polluer la discussion 
Hors ligne
#3 google, crawler
Re : Page connue de Google depuis plusieurs mois – Détectée, non indexée
Meilleure réponse
Bonjour,
Comme Tarifs passe très bien avec exactement la même infra, je regarderais plutôt le title et le H1, s'ils sont proches de ceux de l'accueil, Google peut juger la page redondante et ne pas la crawler. Je testerais un title bien différent, centré sur une prestation précise, puis j'attendrais quelques semaines.
Hors ligne
Pages : 1
Accueil › Clinique SEO / WEB › Page connue de Google depuis plusieurs mois – Détectée, non indexée
Haut