#1 google, script, python, liens, trafic
♦️Script gratuit qui exploite la fuite Google Content Warehouse !
Salut à tous,
Dans la fuite de la doc interne de Google (Content Warehouse, 2024), deux attributs sont passés inaperçus : siteFocusScore et siteRadius. Google transforme vos pages en vecteurs, calcule le centre thématique du site, et mesure à quel point chaque page s'en éloigne.
En brefles pages loin du cœur de votre site diluent votre autorité thématique. Script ci-dessous : vous donnez l'URL, il calcule tout, gratuitement et en local.
j'ai concocté un petit script py pour reproduire cette modélisation en local afin d'analyser nos sites (en partie) comme google (sur ces 2 angles siteFocusScore et siteRadius dans ce cas)
 Lancement
python semfocus.py https://votre-site.fr
Python 3.9 minimum. Le modèle transformers (1go) se télécharge au premier lancement, ca prend un peu de temps ensuite tout tourne hors ligne.

Pour ceux qui veulent générer des visualisation du même genre voici le github directement : https://github.com/jaffaars/semfocus
Tutoriel plus bas pour ceux qui veulent le scripts directement à copier coller + marche à suivre.
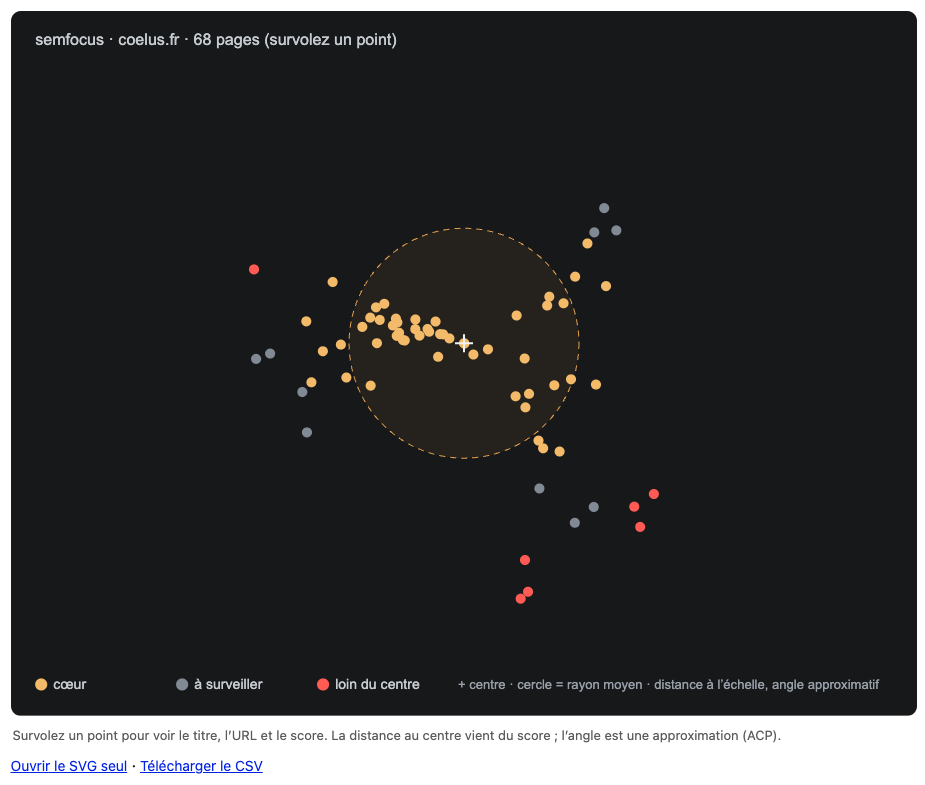
Il lit le sitemap (ou suit les liens internes), garde le contenu principal sans menus ni footer, et sort : le cœur du site, les 10 % de pages les plus éloignées, les paires de pages trop proches, un CSV pour Excel et une carte des pages (SVG à ouvrir dans le navigateur, survolez un point pour voir la page).
 Ce qu'on en fait
Loin du centre, sans trafic : suppression, économie de liens internes ou noindex.
Loin du centre, avec du trafic : on la rattache au cœur par le maillage et recontextualisation logique
Proche du centre mais mal positionnée : Page à renforcer en sémantique et maillage.
Quasi-doublons : fusion + 301, ou bien différencier vraiment les deux pages.
Une nuance importante : la fuite donne le nom des attributs, pas leur poids. C'est un diagnostic, pas une formule magique, et les scores ne se comparent qu'entre pages d'un même site.
 Lancement pas à pas
Installer Python (3.9 minimum) depuis python.org/downloads. Sous Windows, cochez Add python.exe to PATH pendant l'installation.
Copier le script en bas de ce post dans un fichier semfocus.py : Bloc-notes → Enregistrer sous → Type « Tous les fichiers », par exemple dans un dossier Documents\semfocus.
Ouvrir un terminal dans ce dossier : sous Windows, clic droit dans le dossier → Ouvrir dans le Terminal. Sur Mac, ouvrez Terminal, tapez cd + espace et glissez le dossier dans la fenêtre.
Installer les dépendances (une seule fois) :
pip install requests sentence-transformersLancer l'analyse :
python semfocus.py https://votre-site.frSur Mac : pip3 et python3 à la place.
Lire le résultat dans le terminal, puis ouvrir semfocus-votre-site.fr.csv et la carte semfocus-votre-site.fr.svg, créés dans le même dossier.
Le script (semfocus.py)
"""semfocus : mesure le focus sémantique d'un site (idée de siteFocusScore / siteRadius).
Installation : pip install requests sentence-transformers
Usage : python semfocus.py https://exemple.fr
Options : --max 300 (pages analysées)
--model intfloat/multilingual-e5-small (plus rapide, moins précis)
--exclude REGEX (adresses écartées ; par défaut archives WordPress, pagination, flux)
--core REGEX (pages qui définissent le centre : accueil, pages produit...)
--z 2.5 (seuil d'écart robuste pour « loin du centre »)
--utility REGEX (pages utilitaires mises à part ; par défaut contact, mentions légales, confidentialité...)
--refresh (retélécharge les pages au lieu de reprendre le cache)
--cache-hours 24 (durée de validité des pages en cache)
"""
import argparse, codecs, csv, gzip, hashlib, html, json, os, re, sys, time
from collections import Counter
from concurrent.futures import ThreadPoolExecutor
from html.parser import HTMLParser
from urllib.parse import unquote, urljoin, urlparse, urldefrag
import xml.etree.ElementTree as ET
import numpy as np
import requests
SKIP_EXT = re.compile(r"\.(jpe?g|png|gif|webp|avif|svg|pdf|zip|rar|mp4|mp3|css|js|json|xml|txt|ico|woff2?)$", re.I)
SKIP_TAGS = {"script", "style", "noscript", "svg", "nav", "header", "footer", "aside", "form", "iframe", "template", "button", "select"}
BLOCKS = {"p", "li", "h1", "h2", "h3", "h4", "h5", "h6", "td", "th", "blockquote", "pre", "div", "section", "dd", "dt", "figcaption", "br"}
MAIN = ("main", "article")
# Archives et listes (catégories, étiquettes, auteurs, pagination, flux, recherche) : des pages d'extraits qui
# tombent forcément près du centre et forment de fausses paires. Remplaçable par --exclude ("" pour tout garder).
DEFAULT_EXCLUDE = (r"/(category|categorie|categories|tag|tags|etiquette|author|auteur)/|/page/\d+/?$|/feed/?$"
r"|/(wp-json|wp-admin|wp-login)|[?&](s|p|page_id|replytocom|amp)=")
# Pages utilitaires : hors sujet par nature, elles sortiraient en tête des pages « loin du centre » sur tous les sites.
# Listées à part, sans peser sur le centre ni sur le seuil. Remplaçable par --utility ("" pour les traiter comme les autres).
DEFAULT_UTILITY = (r"/(contact|nous-contacter|mentions-legales|legal|legal-notice|imprint|impressum|confidentialite"
r"|politique-de-confidentialite|privacy|privacy-policy|cookies?|politique-de-cookies|cgu|cgv"
r"|conditions-generales[\w-]*|terms[\w-]*|a-?propos|qui-sommes-nous|about|about-us|plan-du-site)/?$")
# Écart minimal : sur un site à gabarit (fiches très semblables), la dispersion est minuscule et le moindre écart
# dépasserait le seuil. L'échelle ne descend pas sous 20 % de la distance médiane au centre : avec --z 2.5, une page
# n'est signalée que si elle est au moins 1,5 fois plus loin du centre que la page médiane.
MIN_SPREAD = 0.2
CHUNK_WORDS = 300 # e5 lit 512 tokens au plus : environ 300 mots en français, marge comprise
MAX_CHUNKS = 12 # au-delà (≈ 3 600 mots), la suite de la page n'est pas lue
os.environ.setdefault("HF_HUB_DISABLE_SYMLINKS_WARNING", "1") # avertissement sans conséquence sous Windows
os.environ.setdefault("HF_HUB_VERBOSITY", "error")
http = requests.Session()
http.headers["User-Agent"] = "Mozilla/5.0 (compatible; semfocus/1.0)"
failures = Counter() # pages non récupérées, par motif
CACHE_VERSION = 2 # à augmenter quand le contenu d'une page en cache change de forme
page_cache, cache_hits = {}, Counter() # pages déjà téléchargées (adresse demandée -> page), reprises d'un passage précédent
# Paramètres de suivi et de tri : la même page sous une autre adresse
TRACKING = re.compile(r"^(utm_\w+|gclid|gbraid|wbraid|fbclid|msclkid|mc_cid|mc_eid|_ga|_gl|orderby|replytocom)$", re.I)
def get(url):
"""GET poli : patiente et réessaie si le site limite le débit (429, 503)."""
for attempt in range(4):
try:
r = http.get(url, timeout=15)
except requests.RequestException:
failures["réseau"] += 1
return None
if r.status_code in (429, 503) and attempt < 3:
wait = r.headers.get("Retry-After", "")
time.sleep(min(int(wait), 60) if wait.isdigit() else 10 * (attempt + 1))
continue
if r.status_code != 200:
failures[f"HTTP {r.status_code}"] += 1
return None
return r
return None
def host(url):
return urlparse(url).netloc.lower().removeprefix("www.")
def normalize_lang(tag):
"""Balise de langue complète, à la casse recommandée par BCP 47 : « pt_br » -> « pt-BR », « ZH-hans-cn » -> « zh-Hans-CN »."""
parts = [p for p in re.split(r"[-_]", (tag or "").strip()) if p]
if not parts or not re.fullmatch(r"[A-Za-z]{2,3}", parts[0]):
return ""
out = [parts[0].lower()]
for p in parts[1:]:
if len(p) == 1: # extension ou usage privé (-x-..., -u-...) : la suite ne désigne plus une langue
break
if re.fullmatch(r"[A-Za-z]{4}", p):
out.append(p.title()) # écriture : Hans, Latn
elif re.fullmatch(r"[A-Za-z]{2}|\d{3}", p):
out.append(p.upper()) # région : BR, 419
else:
out.append(p.lower())
return "-".join(out)
def language_groups(tags):
"""Langue de regroupement de chaque page. Les variantes régionales restent séparées quand le site en a vraiment
plusieurs pour une même langue (pt-BR et pt-PT) ; un simple mélange de « fr » et « fr-FR », fréquent d'un gabarit
à l'autre, est ramené à « fr » pour ne pas couper le site en deux."""
variants = {}
for t in tags:
if "-" in t:
variants.setdefault(t.split("-")[0], set()).add(t)
return [t if len(variants.get(t.split("-")[0], ())) >= 2 else t.split("-")[0] for t in tags]
def clean(url):
url = urldefrag(url)[0]
if "?" in url:
base, query = url.split("?", 1)
query = "&".join(q for q in query.split("&") if q and not TRACKING.match(q.split("=")[0]))
url = base + "?" + query if query else base
return url.rstrip("/")
def page_key(url):
"""Clé de comparaison d'une adresse : sans protocole, www, barre finale ni encodage en %."""
u = urlparse(clean(url))
return host(url), unquote(u.path).strip().rstrip("/"), unquote(u.query)
def same_page(a, b):
"""Même page à http/https, www et barre finale près (pour comparer une adresse à sa canonical)."""
return page_key(a) == page_key(b) # %E2%80%AF == U+202F
class Page(HTMLParser):
"""Texte par blocs, sans menus, en-têtes, pieds de page ni scripts ; <main> ou <article> en priorité.
Les blocs faits surtout de liens (listes de sujets, nuages de tags, fils d'Ariane) sont écartés."""
def __init__(self):
super().__init__(convert_charrefs=True)
self.skip = self.main = self.link = 0
self.buf, self.blocks, self.main_blocks, self.links, self.body_links = [], [], [], [], []
self.title, self.in_title, self.noindex, self.lang, self.canonical = "", False, False, "", ""
def flush(self):
text = " ".join("".join(t for t, _ in self.buf).split())
linked = len("".join(t for t, in_link in self.buf if in_link).strip())
if text and linked <= 0.5 * len(text):
self.blocks.append(text)
if self.main:
self.main_blocks.append(text)
self.buf = []
def handle_starttag(self, tag, attrs):
a = dict(attrs)
if tag == "html":
self.lang = normalize_lang(a.get("lang"))
if tag == "a" and a.get("href"):
self.links.append(a["href"])
if not self.skip: # lien placé dans le contenu, hors menus, en-tête, pied de page et colonnes
self.body_links.append((a["href"], self.main > 0))
if tag == "meta" and (a.get("name") or "").lower() in ("robots", "googlebot") and "noindex" in (a.get("content") or "").lower():
self.noindex = True
if tag == "link" and "canonical" in (a.get("rel") or "").lower().split() and a.get("href") and not self.canonical:
self.canonical = a["href"].strip()
if tag in BLOCKS or tag in SKIP_TAGS or tag in MAIN:
self.flush()
self.in_title |= tag == "title"
self.skip += tag in SKIP_TAGS
self.main += tag in MAIN
self.link += tag == "a"
def handle_endtag(self, tag):
if tag in BLOCKS or tag in SKIP_TAGS or tag in MAIN:
self.flush()
if tag == "title":
self.in_title = False
if tag == "a" and self.link:
self.link -= 1
if tag in SKIP_TAGS and self.skip:
self.skip -= 1
if tag in MAIN and self.main:
self.main -= 1
def handle_data(self, data):
if self.in_title:
self.title += data
elif not self.skip:
self.buf.append((data, self.link > 0))
def fetch(url):
if url in page_cache:
cache_hits["pages"] += 1
return page_cache[url]
r = get(url)
ctype = r.headers.get("Content-Type", "") if r else ""
if not r or "html" not in ctype:
return None
if host(r.url) != host(url): # redirection vers un autre site : ce n'est plus une page du site
failures["redirigée vers un autre site"] += 1
return None
if "charset" not in ctype.lower():
# Sans jeu de caractères dans l'en-tête, requests suppose du latin-1 : lire la balise meta, sinon UTF-8
m = re.search(rb"charset=[\x22\x27]?([\w-]+)", r.content[:4096])
r.encoding = "utf-8"
if m:
try:
r.encoding = codecs.lookup(m.group(1).decode("ascii")).name
except LookupError:
pass
p = Page()
p.feed(r.text)
p.flush()
in_main = sum(len(b.split()) for b in p.main_blocks) >= 80
blocks = p.main_blocks if in_main else p.blocks
links = [clean(urljoin(r.url, l)) for l in p.links]
body_links = sorted({clean(urljoin(r.url, l)) for l, m in p.body_links if m or not in_main})
# noindex par en-tête HTTP (X-Robots-Tag), en plus de la balise meta
noindex = p.noindex or "noindex" in r.headers.get("X-Robots-Tag", "").lower()
# canonical vers une autre adresse : Google retient l'autre page, celle-ci ne compte pas
canonical = urljoin(r.url, p.canonical) if p.canonical else ""
elsewhere = bool(canonical) and not same_page(canonical, r.url)
page = {"url": clean(r.url), "title": " ".join(p.title.split()), "blocks": blocks, "links": links,
"body_links": body_links, "noindex": noindex, "canonical_elsewhere": elsewhere, "lang": p.lang,
"fetched": time.time(), "cache": CACHE_VERSION}
page_cache[url] = page
return page
def load_page_cache(path, hours):
try:
with open(path, encoding="utf-8") as f:
data = json.load(f)
except (OSError, ValueError):
return
limit = time.time() - hours * 3600
page_cache.update({u: p for u, p in data.items() if p.get("fetched", 0) >= limit and p.get("cache") == CACHE_VERSION})
def save_page_cache(path):
os.makedirs(os.path.dirname(path), exist_ok=True)
with open(path, "w", encoding="utf-8") as f:
json.dump(page_cache, f, ensure_ascii=False)
def encode(model_name, chunks, path):
"""Vecteurs des passages, repris du cache quand le texte et le modèle n'ont pas changé."""
keys = [hashlib.sha1(c.encode("utf-8")).hexdigest() for c in chunks]
known = {}
try:
with np.load(path) as d:
known = dict(zip(d["keys"].tolist(), d["vecs"]))
except (OSError, ValueError, KeyError):
pass
todo = {k: c for k, c in zip(keys, chunks) if k not in known}
print(f"{len(chunks)} passages, dont {sum(k not in todo for k in keys)} repris du cache")
if todo:
from sentence_transformers import SentenceTransformer
model = SentenceTransformer(model_name)
vecs = model.encode(list(todo.values()), normalize_embeddings=True, batch_size=16, show_progress_bateau=True)
known.update(zip(todo, vecs.astype(np.float32)))
os.makedirs(os.path.dirname(path), exist_ok=True)
np.savez(path, keys=np.array(list(known)), vecs=np.array(list(known.values())))
return np.array([known[k] for k in keys], dtype=np.float64)
def sitemap_urls(root):
robots = get(urljoin(root, "/robots.txt"))
queue = re.findall(r"(?im)^\s*sitemap:\s*(\S+)", robots.text) if robots else []
queue = queue or [urljoin(root, "/sitemap.xml"), urljoin(root, "/sitemap_index.xml")]
seen, pages = set(), []
while queue and len(seen) < 100:
url = queue.pop(0)
if url in seen:
continue
seen.add(url)
r = get(url)
if not r:
continue
data = gzip.decompress(r.content) if r.content[:2] == b"\x1f\x8b" else r.content
try:
tree = ET.fromstring(data)
except ET.ParseError:
continue
index = tree.tag.endswith("sitemapindex")
for entry in tree:
for child in entry:
if child.tag.split("}")[-1] == "loc" and child.text:
(queue if index else pages).append(child.text.strip())
return list(dict.fromkeys(pages))
def collect(root, limit, exclude=None):
site = host(root)
excluded = (lambda u: bool(exclude.search(u))) if exclude else (lambda u: False)
urls = [u for u in sitemap_urls(root) if host(u) == site and not SKIP_EXT.search(urlparse(u).path)]
pages, seen = [], set()
with ThreadPoolExecutor(4) as pool:
if urls:
n = len(urls)
urls = [u for u in urls if not excluded(u)]
print(f"Sitemap : {n} adresses" + (f", {n - len(urls)} exclues (archives, --exclude)" if n > len(urls) else ""), end="")
if len(urls) > limit: # échantillon réparti sur tout le sitemap
cache_hits["échantillon"] = len(urls)
urls = [urls[int(i * len(urls) / limit)] for i in range(limit)]
print(f", échantillon de {limit}", end="")
print()
pages = [p for p in pool.map(fetch, urls) if p]
else:
print("Pas de sitemap : exploration des liens internes")
todo = [clean(root)]
seen.add(todo[0])
kept = 0 # les archives sont parcourues pour trouver des liens, mais ne comptent pas dans --max
while todo and kept < limit:
batch, todo = todo[:16], todo[16:]
for p in pool.map(fetch, batch):
if not p or kept >= limit:
continue
pages.append(p)
kept += not excluded(p["url"])
for l in p["links"]:
if host(l) == site and l not in seen and not SKIP_EXT.search(urlparse(l).path):
seen.add(l)
todo.append(l)
if cache_hits["pages"]:
print(f"{cache_hits['pages']} pages reprises du cache (--refresh pour les retélécharger)")
if failures:
print("Pages non récupérées : " + ", ".join(f"{n} ({k})" for k, n in failures.items()))
unique, skipped = {}, Counter()
for p in pages:
if p["noindex"]:
skipped["noindex"] += 1
elif p["canonical_elsewhere"]:
skipped["canonical vers une autre page"] += 1
elif excluded(p["url"]): # y compris une adresse du sitemap redirigée vers une archive
skipped["archive ou --exclude"] += 1
else:
unique.setdefault(p["url"], p)
if skipped:
print("Pages écartées : " + ", ".join(f"{n} ({k})" for k, n in skipped.items()))
return list(unique.values())
def strip_boilerplate(pages):
"""Retire les blocs répétés sur plus de 30 % des pages (menus, encarts, mentions)
et les fragments de moins de 5 mots (dates, compteurs, boutons, pseudos)."""
for p in pages:
p["blocks"] = [b for b in p["blocks"] if len(b.split()) >= 5]
count = {}
for p in pages:
for b in set(p["blocks"]):
count[b] = count.get(b, 0) + 1
limit = max(2, 0.3 * len(pages))
for p in pages:
p["text"] = " ".join(b for b in p["blocks"] if count[b] <= limit)
# Nom du site en tête ou en fin de titre (« Article - Mon site ») : commun à toutes les pages, il les rapproche
# toutes du centre. Retiré du texte encodé s'il revient sur plus de 30 % des pages (le titre affiché reste entier).
sep = re.compile(r"\s+[-|\u2013\u2014\u00b7:\u00bb]\s+")
ends = Counter()
for p in pages:
parts = sep.split(p["title"])
if len(parts) > 1:
ends.update({("fin", parts[-1].lower()), ("début", parts[0].lower())})
common = {e for e, n in ends.items() if n > limit}
for p in pages:
parts = sep.split(p["title"])
if len(parts) > 1 and ("fin", parts[-1].lower()) in common:
parts = parts[:-1]
if len(parts) > 1 and ("début", parts[0].lower()) in common:
parts = parts[1:]
p["topic"] = " - ".join(parts)
def short(url, root):
u = urlparse(url)
return (u.path or "/") + ("?" + u.query if u.query else "")
def write_svg(path, C, verdicts, pages, focus, root):
"""Carte radiale : distance au centre = 1 - focus (mise à l'échelle), angle = ACP des vecteurs centrés (approximatif).
Le cercle est le rayon moyen du site, et les pages loin du centre sont dehors."""
_, _, vt = np.linalg.svd(C, full_matrices=False)
ang = np.arctan2(C @ vt[1], C @ vt[0])
dist = 1 - focus
dist = (dist - dist.min()) / max(np.ptp(dist), 1e-9) # mise à l'échelle : de la page la plus centrale à la plus éloignée
w, h, m = 900, 700, 60
k = min((w - 2 * m) / 2, (h - 2 * m - 60) / 2)
cx, cy = w / 2, (h - 60) / 2 + 10
xy = np.c_[np.cos(ang) * dist, np.sin(ang) * dist]
r = dist.mean() * k
colors = {"cœur": "#ECC46A", "à surveiller": "#8E959F", "loin du centre": "#F0645A", "page utilitaire": "#5B8DB8"}
out = [f'<svg xmlns="http://www.w3.org/2000/svg" viewBox="0 0 {w} {h}" font-family="Segoe UI, Arial, sans-serif">',
f'<rect width="{w}" height="{h}" fill="#18191C"/>',
f'<text x="24" y="34" fill="#CDD1D6" font-size="16">semfocus · {html.escape(host(root))} · {len(pages)} pages (survolez un point)</text>',
f'<circle cx="{cx}" cy="{cy}" r="{r:.1f}" fill="#DCAB4C" fill-opacity=".07" stroke="#DCAB4C" stroke-dasharray="6 5"/>']
for i in np.argsort(-focus): # les pages éloignées sont dessinées en dernier, au-dessus
tip = html.escape(f"{pages[i]['title']}\n{pages[i]['url']}\nfocus {focus[i]:.3f} · {verdicts[i]}")
out.append(f'<circle cx="{cx + xy[i, 0] * k:.1f}" cy="{cy - xy[i, 1] * k:.1f}" r="5" fill="{colors[verdicts[i]]}"><title>{tip}</title></circle>')
out.append(f'<path d="M{cx - 9} {cy}h18M{cx} {cy - 9}v18" stroke="#F2F3F5" stroke-width="2"/>')
y, x = h - 26, 24
for label, col in colors.items():
out.append(f'<circle cx="{x + 6}" cy="{y - 5}" r="6" fill="{col}"/><text x="{x + 18}" y="{y}" fill="#CDD1D6" font-size="14">{label}</text>')
x += 132
out.append(f'<text x="{x}" y="{y}" fill="#A3A9B2" font-size="13">+ centre · cercle = rayon moyen · angle approximatif</text></svg>')
with open(path, "w", encoding="utf-8") as f:
f.write("\n".join(out))
def main():
if hasattr(sys.stdout, "reconfigure"):
sys.stdout.reconfigure(encoding="utf-8")
ap = argparse.ArgumentParser(description="Focus sémantique d'un site")
ap.add_argument("url")
ap.add_argument("--max", type=int, default=300)
ap.add_argument("--model", default="intfloat/multilingual-e5-base",
help="modèle d'embedding (intfloat/multilingual-e5-small : plus rapide, moins précis)")
ap.add_argument("--exclude", default=DEFAULT_EXCLUDE,
help="expression régulière des adresses à écarter (défaut : archives WordPress, pagination, flux ; \"\" pour tout garder)")
ap.add_argument("--core", default="",
help="expression régulière sur le chemin des pages qui définissent le centre, ex. \"^/$|^/produits/\"")
ap.add_argument("--z", type=float, default=2.5,
help="écart robuste (en MAD) sous la médiane à partir duquel une page est « loin du centre »")
ap.add_argument("--utility", default=DEFAULT_UTILITY,
help="expression régulière sur le chemin des pages utilitaires, listées à part (défaut : contact, mentions légales, "
"confidentialité, à propos... ; \"\" pour les traiter comme les autres)")
ap.add_argument("--refresh", action="store_true", help="retélécharge les pages au lieu de reprendre le cache")
ap.add_argument("--cache-hours", type=float, default=24, help="durée de validité des pages en cache (défaut : 24 h)")
args = ap.parse_args()
root = args.url if "://" in args.url else "https://" + args.url
cache_dir = os.path.join(".semfocus-cache", re.sub(r"[^\w.-]", "_", host(root)))
if not args.refresh:
load_page_cache(os.path.join(cache_dir, "pages.json"), args.cache_hours)
exclude = re.compile(args.exclude, re.I) if args.exclude else None
core_re = re.compile(args.core, re.I) if args.core else None
utility_re = re.compile(args.utility, re.I) if args.utility else None
pages = collect(root, args.max, exclude)
save_page_cache(os.path.join(cache_dir, "pages.json"))
strip_boilerplate(pages)
thin = [p for p in pages if len(p["text"].split()) < 50]
pages = [p for p in pages if len(p["text"].split()) >= 50]
if thin: # listes de liens, pages d'accueil très visuelles, fiches presque vides : pas assez de texte pour un vecteur fiable
print(f"{len(thin)} pages écartées faute de texte (moins de 50 mots) : "
+ ", ".join(short(p["url"], root) for p in thin[:8]) + (", ..." if len(thin) > 8 else ""))
if len(pages) < 5:
sys.exit(f"Seulement {len(pages)} pages avec assez de texte : impossible de calculer un centre.")
print(f"{len(pages)} pages indexables d'au moins 50 mots\n")
is_core = np.array([bool(core_re and core_re.search(short(p["url"], root))) for p in pages])
is_util = np.array([bool(utility_re and utility_re.search(short(p["url"], root))) for p in pages]) & ~is_core
if core_re:
if not is_core.any():
sys.exit(f"--core « {args.core} » ne correspond à aucune page analysée (l'expression est comparée au chemin : /, /produits/exemple...).")
print(f"Centre défini par {is_core.sum()} pages (--core) : " + ", ".join(short(p["url"], root) for p, c in zip(pages, is_core) if c)[:300] + "\n")
e5 = "e5" in args.model
# Pages découpées en passages d'environ 300 mots (le modèle tronque au-delà de 512 tokens), le titre en tête de
# chaque passage ; le vecteur de la page est la moyenne de ses passages, pondérée par leur longueur.
chunks, owner, weight = [], [], []
for i, p in enumerate(pages):
words = p["text"].split()
for start in range(0, min(len(words), CHUNK_WORDS * MAX_CHUNKS), CHUNK_WORDS):
part = words[start:start + CHUNK_WORDS]
chunks.append(("passage: " if e5 else "") + p["topic"] + ". " + " ".join(part))
owner.append(i)
weight.append(len(part))
V = encode(args.model, chunks, os.path.join(cache_dir, "vecteurs-" + re.sub(r"[^\w.-]", "_", args.model) + ".npz"))
E = np.zeros((len(pages), V.shape[1]))
np.add.at(E, owner, V * np.array(weight)[:, None])
E /= np.linalg.norm(E, axis=1, keepdims=True)
# Un centre par langue (5 pages au moins) : une page traduite se compare aux pages de sa langue.
# Avec --core, le centre de chaque langue est la moyenne de ses pages cœur (à défaut, celles de tout le site).
langs = np.array(language_groups([p["lang"] for p in pages]))
counts = Counter(langs)
if len(counts) > 1:
print("Langues : " + ", ".join(f"{l or '?'} {n}" for l, n in counts.most_common()))
groups = [np.where(langs == l)[0] for l, n in counts.items() if n >= 5]
rest = np.where([counts[l] < 5 for l in langs])[0]
every = np.arange(len(pages))
focus, z, C = np.zeros(len(pages)), np.zeros(len(pages)), np.zeros_like(E)
for g in groups + ([rest] if len(rest) else []):
ref = g if len(g) >= 5 else every # trop peu de pages dans cette langue : on se réfère à tout le site
centre = ref[~is_util[ref]] if (~is_util[ref]).sum() >= 5 else ref # les pages utilitaires ne définissent pas le site
if core_re: # pages cœur de la langue, à défaut celles de tout le site
centre = ref[is_core[ref]] if is_core[ref].any() else every[is_core]
mean = E[centre].mean(0)
focus[g] = E[g] @ (mean / np.linalg.norm(mean))
# Les paires se comparent sans le "fond commun" de la langue (moyenne de toutes ses pages, cœur ou non)
C[g] = E[g] - E[ref].mean(0)
# Écart robuste à la médiane, en MAD (insensible aux pages extrêmes) : une page n'est signalée que si elle
# décroche vraiment, pas parce qu'elle fait partie des 10 % les plus bas. Calculé langue par langue, chaque
# langue ayant son propre centre.
for g in groups + ([rest] if len(rest) else []):
ref = g if len(g) >= 5 else every
ref = ref[~is_util[ref]] if (~is_util[ref]).sum() >= 5 else ref
med = np.median(focus[ref])
mad = 1.4826 * np.median(np.abs(focus[ref] - med))
z[g] = (focus[g] - med) / max(mad, MIN_SPREAD * (1 - med), 1e-9)
# Proximité entre pages sur les vecteurs centrés : sans le "fond commun" du site, les écarts redeviennent lisibles
Cn = C / np.maximum(np.linalg.norm(C, axis=1, keepdims=True), 1e-9)
S = Cn @ Cn.T
np.fill_diagonal(S, -1)
S[langs[:, None] != langs[None, :]] = -1 # une page et sa traduction se ressemblent forcément
S[is_util, :] = S[:, is_util] = -1 # mentions légales et confidentialité se ressemblent : sans intérêt
near = S.argmax(1)
order = np.argsort(focus)
# Maillage interne : liens placés dans le contenu, d'une page analysée vers une autre
index = {page_key(p["url"]): i for i, p in enumerate(pages)}
out_links = [{index[k] for k in map(page_key, p["body_links"]) if k in index} - {i} for i, p in enumerate(pages)]
inbound = Counter(j for links in out_links for j in links)
def linked(i, j):
a, b = j in out_links[i], i in out_links[j]
return "liées dans les deux sens" if a and b else "lien dans un seul sens" if a or b else "aucun lien entre elles"
print(f"\nFocus médian : {np.median(focus):.3f} rayon moyen (1 - focus) : {np.mean(1 - focus):.3f}")
print("Les valeurs dépendent du modèle : comparez les pages entre elles, pas à un seuil absolu.\n")
print("== Cœur du site (les plus proches du centre) ==")
for i in order[::-1][:5]:
print(f" {focus[i]:.3f} {short(pages[i]['url'], root)} {pages[i]['title'][:60]}")
far = [i for i in order if z[i] <= -args.z and not is_util[i]]
print(f"\n== Loin du centre (écart ≤ -{args.z:g} MAD) : à croiser avec le trafic avant toute décision ==")
for i in far:
print(f" {focus[i]:.3f} z {z[i]:+.1f} {short(pages[i]['url'], root)} {pages[i]['title'][:60]}")
if not far:
print(" Aucune page ne décroche nettement. Les plus basses, pour information :")
for i in [i for i in order if not is_util[i]][:3]:
print(f" {focus[i]:.3f} z {z[i]:+.1f} {short(pages[i]['url'], root)} {pages[i]['title'][:60]}")
if is_util.any():
print("\n== Pages utilitaires (mises à part : ni dans le centre, ni dans les alertes) ==")
for i in order:
if is_util[i]:
print(f" {focus[i]:.3f} {short(pages[i]['url'], root)} {pages[i]['title'][:60]}")
iu = np.triu_indices(len(pages), 1)
pairs = S[iu]
print("\n== Paires les plus proches : doublons ou cannibalisation à vérifier ==")
for k in np.argsort(pairs)[::-1][:10]:
i, j = iu[0][k], iu[1][k]
print(f" {pairs[k]:.3f} {short(pages[i]['url'], root)} <-> {short(pages[j]['url'], root)} [{linked(i, j)}]")
orphans = [i for i in order[::-1] if not inbound[i] and not is_util[i] and short(pages[i]["url"], root) != "/"]
print("\n== Maillage interne (liens dans le contenu, entre pages analysées) ==")
print(f" {sum(map(len, out_links))} liens ; {len(orphans)} pages sur {len(pages)} ne reçoivent aucun lien depuis le contenu d'une autre page")
if orphans:
print(" Les plus proches du centre parmi elles (les premières à relier) :")
for i in orphans[:5]:
print(f" {focus[i]:.3f} {short(pages[i]['url'], root)} {pages[i]['title'][:60]}")
print(" Les liens des menus, du pied de page et des pages d'archives exclues ne sont pas comptés.")
if cache_hits["échantillon"]:
print(f" Échantillon de {args.max} pages sur {cache_hits['échantillon']} : ce décompte est partiel, les liens venant des autres pages manquent.")
watch = 0.6 * args.z # 1,5 MAD avec le seuil par défaut
verdicts = ["page utilitaire" if u else "loin du centre" if v <= -args.z else "à surveiller" if v <= -watch else "cœur"
for v, u in zip(z, is_util)]
print(f"\nVerdicts : {verdicts.count('cœur')} cœur, {verdicts.count('à surveiller')} à surveiller, {verdicts.count('loin du centre')} loin du centre"
+ (f", {verdicts.count('page utilitaire')} utilitaires" if is_util.any() else ""))
out = f"semfocus-{host(root)}.csv"
with open(out, "w", newline="", encoding="utf-8-sig") as f:
w = csv.writer(f, delimiter=";")
w.writerow(["url", "titre", "focus", "écart (MAD)", "verdict", "page cœur", "mots", "liens entrants", "liens sortants",
"page la plus proche", "similarité", "lien avec cette page"])
for i in order:
w.writerow([pages[i]["url"], pages[i]["title"], f"{focus[i]:.4f}", f"{z[i]:+.2f}", verdicts[i], "oui" if is_core[i] else "",
len(pages[i]["text"].split()), inbound[i], len(out_links[i]),
*(("", "", "") if is_util[i] else (pages[near[i]]["url"], f"{S[i, near[i]]:.4f}", linked(i, near[i])))])
write_svg(f"semfocus-{host(root)}.svg", C, verdicts, pages, focus, root)
print(f"\nTableau complet : {out}")
print(f"Carte des pages : semfocus-{host(root)}.svg (à ouvrir dans le navigateur)")
if __name__ == "__main__":
main()
Hors ligne
#2 script, maillage, sémantique, contenu
Re : ♦️Script gratuit qui exploite la fuite Google Content Warehouse !
Salut Jaffaar et merci pour le script.
Je l'ai installé, je ne sais pas si dans tes exemples tu as eu le même cas, mais au centre je m'attendais à avoir la home, alors qu'elle arrive chez moi en 17e position (coeur) : pourquoi ?
Ce n'est pas censé être la page qui a le plus de poids / force ?
Pour les pages qui ont les meilleurs scores (focus et verdict) : qu'est-ce qu'il faut en déduire ?
Elles ont un meilleur maillage ? Une meilleure thématisation sémantique ? On peut s'appuyer sur elle pour mailler les pages les plus éloignées du centre ?
J'ai des pages "produits" qui sont perdues dans l’arborescence, très peu maillées, contenu moyen et pourtant elles ont un gros score.
Hors ligne
#3 script, lien, maillage, sémantique, contenu
Re : ♦️Script gratuit qui exploite la fuite Google Content Warehouse !
@Stone cool pour le retour !
Pour te répondre : le score ne mesure ni la force ni le maillage : le script ne lit aucun lien.
Il compare seulement le texte de chaque page au "centre thématique" du site, c'est-à-dire la moyenne de toutes les pages analysées.
La home en 17e : normal. Elle survole tous tes sujets, donc elle colle rarement à la moyenne. 17e, c'est toujours le cœur.
Les fiches produits en tête : comme elles sont nombreuses et se ressemblent, elles tirent le centre vers elles. Un gros score veut dire "page typique du site", pas "page forte".
Ce qu'on en déduit : le score sert surtout à repérer les pages hors sujet (les 10 % du bas). Il ne dit rien de leur puissance.
Pour mailler une page éloignée : ne prends pas les meilleurs scores, prends la colonne "page la plus proche" du CSV. C'est sa voisine sémantique, donc le lien le plus logique.
Et si ce sont tes produits qui font le centre, c'est une info en soi : ton site parle d'abord "catalogue". Si tu veux qu'il parle d'abord "expertise", c'est le contenu éditorial qu'il faut renforcer 
N'hésite pas à nous publier le screen du svg c'est toujours sympa à voir !
Hors ligne
#4 script, liens, formations
Re : ♦️Script gratuit qui exploite la fuite Google Content Warehouse !
Non merci à toi surtout.
Ok donc, moi perso ça me va si le site est perçu comme un site catalogue : Woocommerce de vente en ligne de formations, pourtant d'aspect plus édito / pages de prestation.
Le but est bien de vendre des inscriptions aux formations : nickel.
Donc si j'ai bien compris :
le script note la typologie du site, la thématisation des pages ;
Plus la page est thématisée sur un sujet précis, mieux elle est notée
Pour approcher les pages éloignées du centre et les optimiser, il faudrait :
que je rethématise le contexte ?
que je maille depuis la page la plus proche ?
les liens qui sont situés dans le préfooter (bloc formations related) ne sont pas considérés / pris en compte dans le calcul ?
J'ai bon ?
Hors ligne
#5
Re : ♦️Script gratuit qui exploite la fuite Google Content Warehouse !
que je rethématise le contexte ?
Oui, le contexte des pages
que je maille depuis la page la plus proche ?
Pour cette partie pas forcement, pour le seo en soi (au dela des deux algo de ce thread) oui
C'est normal d'avoir des pages un peu éloignée du coeur je pense, il faut prendre cela avec des pincettes car ce n'est qu'une partie de l'algo global,
mais maintenant il est possible pour les pages éloignées de les rapprocher en ajoutant du vocabulaire pour mieux mélanger les deux théme et mieux faire le pont entres les sets lexicaux respectifs.
L'idée c'est de minimiser le dilution de l'autorité thématique du site en resserant un peu les mailles sans non plus optimiser à l'extreme, il y a surement des exceptions légitimes à respecter sur nombre de projets.
Hors ligne
#6 google
Re : ♦️Script gratuit qui exploite la fuite Google Content Warehouse !
Meilleure réponse
Franchement c'est sympa comme outil !
Je viens d'essayer et la visualisation parle d'elle même. Ca permet de comprendre comment Google voit votre site en terme d'autorité thématique, et sur quels sujets il faut se concentrer.
Hors ligne
#7 maillage, liens, sémantique, thématique, groupes
Re : ♦️Script gratuit qui exploite la fuite Google Content Warehouse !
@Stone ces deux scores et le graph ne prennent pas du tout en compte les liens ou le maillage mais la thématisation du groupe de page et de chaque page pour situer la distribution thématique pure en quelques sortes.
Par thématique 'pure' j'entends : liée a la sémantique des termes portés par les pages et non au maillage et a la structure qui relie les pages.
@Recreabox on voit directement 3 petits groupes de pages (en rouge) pour lesquels tu pourrais peut être un peu resserer les mailles en ajoutant une meilleur jonctions contextuelle entre le coeur et les groupes excentrés
Hors ligne
#8
Re : ♦️Script gratuit qui exploite la fuite Google Content Warehouse !
Sympa ton outil 
PR incoming
Hors ligne
#9 script, sémantique, maillage, audits, sogliath
Re : ♦️Script gratuit qui exploite la fuite Google Content Warehouse !
Merci @Sogliath pour la contribution sur github : https://github.com/jaffaars/semfocus
Je viens de merger les améliorations de la pull request de notre ami @Sogliath :
Cette PR apporte trois améliorations principalement :
1. Fiabilité sémantique : les pages longues et les pages d'archives ne faussent plus autant le diagnostic.
2. Diagnostic SEO : le croisement entre proximité sémantique et maillage interne apporte une vraie valeur ajoutée.
3. Performances : le cache rend l'outil beaucoup plus pratique pour les audits successifs.
Code du script seul mis à jour dans le thread principal pour ceux qui n'utilisent pas github
Hors ligne
Pages : 1
Accueil › Contenu et sémantique › ♦️Script gratuit qui exploite la fuite Google Content Warehouse !
Haut