#1 claude, robots, logs, serveur, script
logbot, le skill Claude qui analyse vos logs SEO / GEO
En brefUn skill complet (méthode + script Python + référence des robots) qui transforme vos logs nginx ou Apache en rapport SEO et GEO. Il sépare moteurs, IA d'entraînement, IA de recherche et IA qui lisent vos pages à la demande d'un utilisateur, démasque les faux Googlebot et les fausses IA, mesure le gaspillage du budget de crawl et liste les pages que ChatGPT ou Claude ouvrent pour répondre. Gratuit, sans dépendance, à copier plus bas.
 Dernière version, installation en une ligne et zip :
 Dépot github : https://github.com/jaffaars/claude-skills-logbot
Les logs serveur sont la seule source qui dit ce que les robots font vraiment sur votre site. La Search Console n'en donne qu'un résumé, et rien du tout sur les IA. Or c'est justement là que tout bouge : GPTBot, OAI-SearchBot, ChatGPT-User, ClaudeBot, PerplexityBot… ils ne font pas du tout le même travail, et ne valent pas du tout la même chose pour vous.
J'ai donc écrit un skill qui fait le tri
 Ce que fait le skill
Classe chaque requête : moteurs, IA d'entraînement, IA de recherche, IA en lecture à la demande, outils SEO, aperçus sociaux, scripts, navigateurs.
Démasque les faux robots avec les listes d'IP officielles (Google, Bing, OpenAI, Perplexity) et le DNS inverse confirmé (Apple, Yandex, Baidu). Les imposteurs sont sortis des chiffres.
Mesure le budget de crawl de Googlebot : gaspillage, gabarits d'URL les plus crawlés, pages en erreur, fréquence de passage.
Croise avec le sitemap : pages jamais vues par Googlebot, pages crawlées hors sitemap.
Fait le point GEO : quelles IA lisent quoi, et surtout quelles pages les assistants ouvrent pour répondre à leurs utilisateurs.
Repère les robots qui ignorent votre robots.txt, les demandes de llms.txt et les sondes de sécurité.
Rend un rapport d'actions priorisées, pas un tableau brut : Claude interprète les chiffres avec une grille fournie dans le skill.
Les logs restent chez vous : le script tourne sur votre serveur ou votre poste, et Claude ne travaille que sur le rapport agrégé.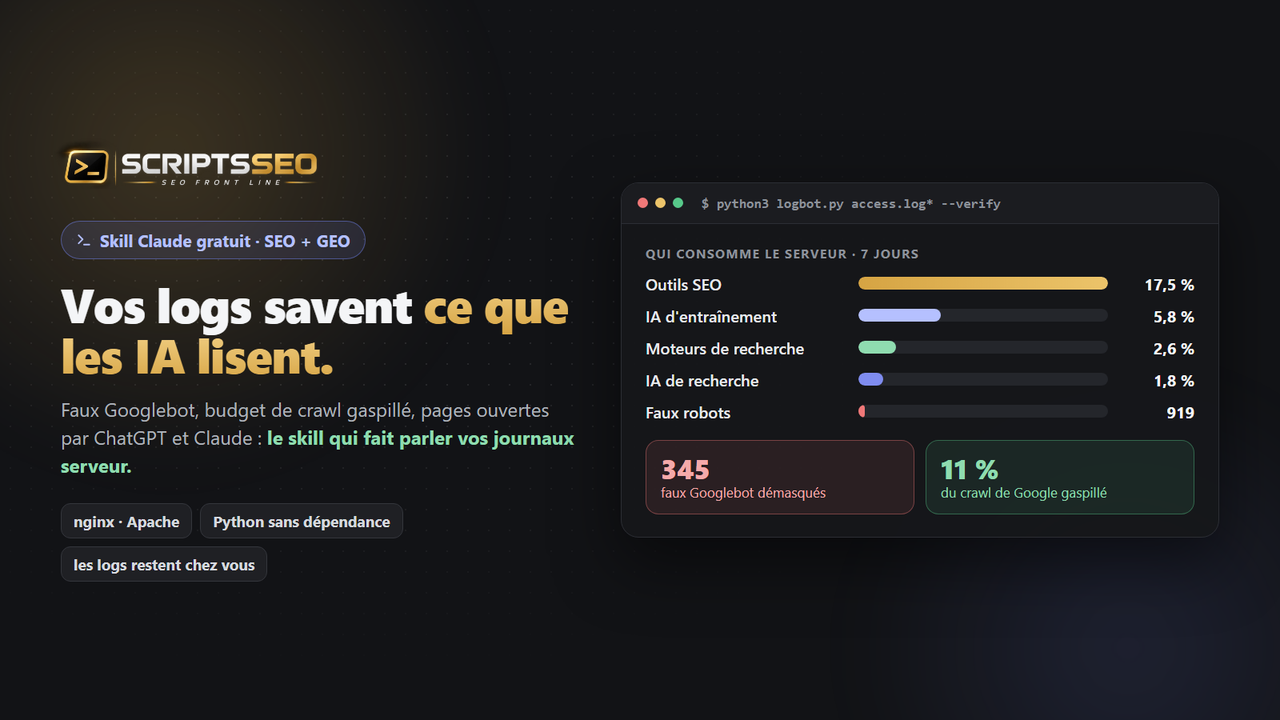
 La distinction qui change tout en GEO
IA d'entraînement (GPTBot, ClaudeBot, Bytespider…) : elles collectent pour entraîner leurs modèles. Aucun visiteur en retour.
IA de recherche (OAI-SearchBot, PerplexityBot, Claude-SearchBot) : elles construisent l'index qui permet d'être cité dans ChatGPT Search, Perplexity ou Claude.
IA à la demande (ChatGPT-User, Claude-User, Perplexity-User) : une IA ouvre votre page à l'instant, parce qu'un utilisateur lui a posé une question. C'est le meilleur indice, côté serveur, que votre page sert de source.
Conséquence pratique : bloquer GPTBot n'empêche pas ChatGPT de vous citer. C'est OAI-SearchBot qui compte pour ça. Le fichier de référence du skill donne la recette robots.txt pour être cité sans nourrir l'entraînement.
 Installation
Le skill tient en 3 fichiers, à recréer avec cette arborescence :
├── SKILL.md
├── references/
│ └── robots.md
└── scripts/
└── logbot.py
Claude Code : une seule commande, git clone https://github.com/jaffaars/claude-skills-logbot ~/.claude/skills/logbot (ou dans .claude/skills/ d'un projet). Claude l'utilisera tout seul dès que vous parlerez de logs ou de crawl.
Claude.ai : téléchargez logbot.zip dans les Releases du dépôt GitHub et ajoutez-le dans les réglages, rubrique des skills (exécution de code activée). Envoyez ensuite votre fichier de logs dans la conversation. Pensez-y : les logs contiennent des IP, donc des données personnelles.
Sans IA : le script scripts/logbot.py marche seul. Il faut Python 3.8 ou plus, sans rien à installer.
Lancement direct du script :
Ou sans le copier sur le serveur, depuis votre poste :
Exemples de demandes à Claude une fois le skill installé :
« Analyse mes logs nginx des 30 derniers jours, dis-moi où part le crawl de Google. »
« Quels robots IA lisent mon site, et lesquels sont faux ? »
« Est-ce que ChatGPT ouvre mes pages ? Lesquelles ? »
 Les limites, honnêtement
Derrière Cloudflare ou un autre CDN, les IP des logs sont celles du CDN : la vérification des robots est fausse tant que le serveur n'enregistre pas l'IP réelle. Le skill vous le signalera.
Anthropic, Meta ou Amazon ne publient pas de liste d'IP exploitée par le script : leurs robots sont jugés au comportement (taux de 404, sondes).
Prenez au moins 30 jours pour le budget de crawl : 7 jours suffisent pour les IA, pas pour juger Googlebot.
 Fichier 1 : SKILL.md
Le cœur du skill : la méthode, les options du script et la grille d'interprétation.
name: logbot
description: Analyse les journaux serveur (access.log nginx ou Apache, fichiers .gz compris) du point de vue SEO et GEO avec un script fourni. Couvre les moteurs (Googlebot, Bingbot…), les robots IA d'entraînement, de recherche et de lecture à la demande (GPTBot, OAI-SearchBot, ChatGPT-User, ClaudeBot, PerplexityBot…), les faux robots, le budget de crawl et son gaspillage, la couverture du sitemap, les pages lues par les IA et les robots qui ignorent robots.txt. À utiliser dès que l'utilisateur parle de logs, de journaux d'accès, de crawl, de budget de crawl, de passage de Googlebot, de « qui crawle mon site », de robots IA, de sa visibilité dans ChatGPT ou Perplexity vue côté serveur, de faux Googlebot ou de charge serveur due aux robots, même s'il ne dit pas « analyse de logs ».
---
# Analyse de journaux SEO et GEO
Les journaux du serveur sont la seule source qui dit ce que les robots font vraiment : quelles pages Googlebot visite et à quel rythme, ce qu'il gaspille, quels robots IA lisent le site et pourquoi, lesquels sont des imposteurs. La Search Console n'en donne qu'un résumé, et rien sur les IA. Ce skill transforme des journaux bruts en décisions.
Le travail se fait en quatre temps : réunir les journaux, lancer le script, interpréter avec la grille ci-dessous, rendre un rapport d'actions.
## 1. Réunir les journaux
- **Où** : nginx `/var/log/nginx/*access.log*`, Apache `/var/log/apache2/` ou `/var/log/httpd/`, hébergement mutualisé : rubrique « logs bruts » ou « raw access » du panneau. Prendre aussi les fichiers tournés (`.1`, `.gz`).
- **Combien** : 30 jours au moins pour le budget de crawl et la couverture du sitemap, car Googlebot ne revoit pas tout chaque semaine. 7 jours suffisent pour les robots IA et les faux robots.
- **Format** : le format « combined », celui par défaut de nginx et d'Apache. Si beaucoup de lignes sont « illisibles », montrer une ligne à l'utilisateur et adapter `LINE_RE` dans le script.
- **CDN** : derrière Cloudflare ou un autre CDN, les IP du journal sont celles du CDN, ce qui fausse toute vérification de robot, et les pages servies depuis le cache n'apparaissent pas. Le signaler et demander les journaux du CDN ou la configuration de l'IP réelle.
- **Données personnelles** : les IP sont des données personnelles. Lancer le script là où sont les journaux (serveur ou poste de l'utilisateur) et ne travailler que sur le rapport agrégé ; ne pas recopier de journaux bruts dans la conversation au-delà de quelques lignes d'exemple.
## 2. Lancer le script
`scripts/logbot.py` : Python 3.8 ou plus, bibliothèque standard seulement. Il lit les fichiers au fil de l'eau, donc plusieurs centaines de Mo ne posent pas de problème.
```bash
python3 scripts/logbot.py /var/log/nginx/access.log* --days 30 --verify \
--sitemap https://exemple.fr/sitemap.xml --robots https://exemple.fr/robots.txt --out rapport-logs
```
| Option | Rôle |
|---|---|
| `--days N` | ne garder que les N derniers jours |
| `--verify` | démasquer les faux robots : listes d'IP officielles (Google, Bing, OpenAI, Perplexity) et DNS inverse confirmé (Apple, Yandex, Baidu). À mettre presque toujours |
| `--dns-limit N` | nombre d'IP vérifiées par DNS pour chaque robot sans liste officielle (100 par défaut) |
| `--sitemap` | URL ou fichier du sitemap (index compris) : adresses jamais vues par Googlebot, crawl hors sitemap |
| `--robots` | URL ou fichier robots.txt : robots qui demandent des adresses interdites |
| `--top N` | longueur des classements |
| `--out DIR` | écrit `rapport.md` et `adresses.csv` (une ligne par adresse, un robot par colonne) au lieu de la sortie standard |
Ordre de grandeur : 300 000 lignes avec `--verify` et le sitemap prennent environ une minute et demie. Sur un serveur distant, le script se lance sans y être copié : `ssh serveur "python3 - /var/log/nginx/access.log* --days 30 --verify" < scripts/logbot.py`.
## 3. Interpréter : la grille
Le rapport donne des chiffres ; la valeur ajoutée, c'est de dire ce qu'ils signifient pour ce site-là. Lire les sections dans cet ordre.
**Vérification** (en-tête et section 3). Sans `--verify`, prévenir que tous les chiffres incluent des imposteurs. Avec, les faux robots sont sortis de leur famille d'origine : citer leur volume et leur comportement, souvent des sondes comme `/.env`. Une colonne « Non vérifié » élevée pour un moteur veut dire que `--dns-limit` est trop bas ; pour un robot IA sans liste officielle, juger au taux de 4xx et aux sondes.
**Qui consomme le serveur** (section 1). Comparer la part des moteurs à celle des outils SEO, des IA d'entraînement et des scripts. Quand les outils SEO ou les IA d'entraînement pèsent plus que les moteurs, c'est de la charge sans retour : proposer Crawl-delay, robots.txt ou une limitation serveur (voir `references/robots.md`). Les « navigateurs » contiennent aussi des robots déguisés : ne pas les présenter comme du trafic humain certain.
**Budget de crawl de Googlebot** (section 4), le cœur de l'analyse SEO :
- *Gaspillage certain* au-dessus d'environ 10 % : à traiter. Redirections : chercher les liens internes qui pointent vers des adresses redirigées, et les passages http vers https ou avec et sans www. 4xx : liens internes cassés, ou anciennes adresses encore liées depuis l'extérieur, à rediriger si elles ont de la valeur. Paramètres de pistage ou de session : à retirer des liens internes.
- *Paramètres* hors pistage (tri, filtres, pagination) : ce n'est pas forcément du gaspillage, car sur un site en PHP `?id=` est souvent l'adresse normale. Regarder les gabarits pour repérer les facettes et les tris qui multiplient les adresses, puis proposer canonical, liens internes retirés ou règles de robots.txt.
- *Gabarits* : les types de pages où part le crawl. Les confronter aux pages qui comptent pour l'activité. Des profils, des tags ou des pages de tri en tête, avec les articles ou les fiches produit loin derrière, signalent un maillage ou une architecture à corriger.
- *Fréquence* : beaucoup de pages vues une seule fois en 30 jours, c'est normal pour des archives, inquiétant pour des pages stratégiques.
**Sitemap** (section 5). Rapporter la couverture à la durée analysée : sur 7 jours, 6 % est banal ; sur 30 jours, moins de la moitié des pages importantes vues est un vrai problème (pages trop profondes, peu liées, ou jugées sans intérêt). Les adresses crawlées hors sitemap sont soit oubliées du sitemap (à ajouter si elles doivent être indexées), soit parasites (à fermer).
**GEO : ce que lisent les IA** (section 6). Distinguer les trois familles, c'est l'essentiel de l'analyse GEO :
- *Lecture à la demande* (ChatGPT-User, Claude-User, Perplexity-User…) : une IA a ouvert la page à l'instant pour répondre à quelqu'un. C'est le meilleur indice, côté serveur, qu'une page sert de source. Lister ces pages : ce sont les « pages sources » du site, à tenir à jour et à structurer pour être reprises (réponse d'abord, faits datés, chiffres sourcés). Des 4xx dans cette famille, quand les robots sont authentiques, montrent des liens morts que les IA continuent de citer : rediriger.
- *Index de recherche* (OAI-SearchBot, PerplexityBot, Claude-SearchBot) : la condition pour être cité dans ChatGPT Search, Perplexity ou Claude. Absents ou bloqués, le site ne peut pas être cité par ces moteurs.
- *Entraînement* (GPTBot, ClaudeBot, Bytespider…) : aucun trafic direct. Les laisser passer ou non est un choix ; rappeler que bloquer GPTBot ne bloque pas OAI-SearchBot.
Les gabarits lus par les IA révèlent parfois des surprises (générateurs d'images, pages de partage, profils) : signaler ce qui consomme sans rien apporter.
**robots.txt** (section 7). Un robot qui demande des adresses interdites ignore robots.txt : seul un blocage serveur l'arrêtera. Vérifier d'abord que l'interdiction est voulue.
**Fichiers techniques** (section 8). Des robots.txt et sitemap très demandés, c'est normal. Pour `llms.txt`, dire combien de requêtes et de qui ; à ce jour, aucun grand assistant n'a documenté son usage, donc ne pas le présenter comme un levier prouvé.
**Sondes** (section 9). Ce n'est pas du SEO, mais le volume dit si le serveur est la cible de scanners. Ces requêtes sont déjà exclues des classements ; renvoyer vers un blocage serveur si le volume est fort.
## 4. Rendre le rapport
Répondre dans la langue de l'utilisateur, avec cette structure :
```markdown
# Analyse des journaux : <site>, <période>
## En bref
3 à 5 phrases : le constat principal SEO, le constat principal GEO, le gaspillage ou le risque le plus coûteux.
## Ce que disent les journaux
Les chiffres qui comptent, chacun suivi de son interprétation (jamais un tableau recopié sans commentaire).
## Actions prioritaires
| Priorité | Action | Pourquoi (chiffre du rapport) | Effort |
Du plus rentable au moins rentable : 5 à 8 actions concrètes (fichier, règle ou page à modifier).
## Limites de l'analyse
Période, vérification faite ou non, CDN, journaux partiels, robots invérifiables.
```
Joindre ou citer `adresses.csv` quand l'utilisateur veut descendre page par page (tri par robot, pages jamais vues par Googlebot, etc.).
## Pièges à éviter
- Conclure sur 2 ou 3 jours de journaux : le crawl varie fortement d'un jour à l'autre.
- Prendre le user-agent pour une preuve : sans vérification, une part des « Googlebot » et des robots IA sont faux.
- Bloquer un vrai Googlebot par erreur : ne jamais limiter les IP vérifiées de Google.
- Confondre exploration et indexation : une page servie en 200 à Googlebot n'est pas forcément indexée.
- Oublier les serveurs multiples : derrière un répartiteur de charge, réunir les journaux de chaque serveur.
Pour la liste des robots, leurs jetons robots.txt, les méthodes de vérification et les recettes de blocage : `references/robots.md`.
Fichier 2 : references/robots.md
La table des robots (famille, jeton robots.txt, méthode de vérification), les recettes robots.txt et les blocages serveur.
## Sommaire
1. Les familles et ce qu'elles valent
2. Table des robots
3. Vérifier un robot
4. Recettes robots.txt
5. Bloquer ou ralentir au niveau du serveur
## 1. Les familles et ce qu'elles valent
| Famille | Ce que fait le robot | Ce que ça rapporte | Décision type |
|---|---|---|---|
| moteur | Explore et indexe pour les résultats classiques (et les réponses IA de Google et Bing) | Trafic organique | Toujours autoriser, surveiller le budget |
| ia-recherche | Construit l'index d'un moteur IA (ChatGPT Search, Perplexity, Claude) | Être cité et recevoir des clics depuis les réponses IA | Autoriser si l'on veut être cité |
| ia-utilisateur | Ouvre une page parce qu'un utilisateur l'a demandée à un assistant, à l'instant | Le meilleur signal GEO : la page sert de source à une réponse | Autoriser ; ces robots agissent pour un humain et ne suivent pas toujours robots.txt |
| ia-entrainement | Collecte pour entraîner des modèles | Aucune visite directe ; présence à long terme dans les connaissances du modèle | Choix stratégique : autoriser, limiter ou bloquer |
| outil-seo | Construit les index de liens des outils (Ahrefs, Semrush, Majestic…) | Votre visibilité dans ces outils, rien côté moteurs | Limiter si la charge est forte |
| apercu | Récupère titre et image quand un lien est partagé | Aperçus soignés sur les réseaux | Autoriser |
Point clé : bloquer GPTBot (entraînement) n'empêche pas ChatGPT de vous citer, car c'est OAI-SearchBot qui alimente ChatGPT Search. Même logique chez Anthropic (ClaudeBot, Claude-SearchBot, Claude-User) et chez Perplexity (PerplexityBot, Perplexity-User). Chez Google, il n'existe pas de robot IA séparé : `Google-Extended` est seulement un jeton robots.txt qui règle l'usage des pages pour Gemini, sans changer l'exploration par Googlebot ni la présence dans les AI Overviews. `Applebot-Extended` joue le même rôle chez Apple.
## 2. Table des robots
| Robot (user-agent) | Éditeur | Famille | Jeton robots.txt | Vérification |
|---|---|---|---|---|
| Googlebot (+ Image, Video, News, Storebot, InspectionTool, GoogleOther, AdsBot) | Google | moteur | Googlebot, Googlebot-Image… | Liste d'IP officielle ou DNS (googlebot.com, google.com, googleusercontent.com) |
| Google-CloudVertexBot | Google | ia-entrainement | Google-CloudVertexBot | Listes d'IP de Google |
| bingbot | Microsoft | moteur | bingbot | Liste d'IP officielle ou DNS (search.msn.com) |
| YandexBot | Yandex | moteur | Yandex | DNS (yandex.ru, .net, .com) |
| Baiduspider | Baidu | moteur | Baiduspider | DNS (baidu.com, baidu.jp) |
| Applebot | Apple | moteur | Applebot (+ Applebot-Extended pour l'IA) | DNS (applebot.apple.com) |
| DuckDuckBot, Qwantbot, SeznamBot, PetalBot | divers | moteur | leur nom | selon l'éditeur |
| OAI-SearchBot | OpenAI | ia-recherche | OAI-SearchBot | openai.com/searchbot.json |
| ChatGPT-User | OpenAI | ia-utilisateur | ChatGPT-User | openai.com/chatgpt-user.json |
| GPTBot | OpenAI | ia-entrainement | GPTBot | openai.com/gptbot.json |
| PerplexityBot | Perplexity | ia-recherche | PerplexityBot | perplexity.ai/perplexitybot.json |
| Perplexity-User | Perplexity | ia-utilisateur | Perplexity-User | perplexity.ai/perplexity-user.json |
| Claude-SearchBot | Anthropic | ia-recherche | Claude-SearchBot | non exploitée par le script : juger au comportement |
| Claude-User | Anthropic | ia-utilisateur | Claude-User | idem |
| ClaudeBot | Anthropic | ia-entrainement | ClaudeBot | idem |
| MistralAI-User | Mistral | ia-utilisateur | MistralAI-User | aucune |
| DuckAssistBot | DuckDuckGo | ia-utilisateur | DuckAssistBot | aucune |
| meta-externalagent, meta-externalfetcher | Meta | ia-entrainement, ia-utilisateur | meta-externalagent | aucune |
| Amazonbot, Bytespider, CCBot, cohere-ai, Diffbot, AI2Bot | divers | ia-entrainement | leur nom | aucune (Bytespider ignore souvent robots.txt) |
| AhrefsBot, SemrushBot, MJ12bot, DotBot, BLEXBot, DataForSeoBot, SEOkicks, Barkrowler | outils | outil-seo | leur nom | inutile en pratique |
| facebookexternalhit, Twitterbot, LinkedInBot, Slackbot, Discordbot, TelegramBot, WhatsApp | réseaux | apercu | leur nom | inutile en pratique |
Les noms évoluent : quand un user-agent inconnu revient souvent dans « Autres robots », chercher sa page officielle et l'ajouter à la liste `BOTS` du script (motif, nom, famille, jeton, vérification).
## 3. Vérifier un robot
Un user-agent se copie en une ligne : sur un site moyen, une part notable des « Googlebot » et des « ChatGPT-User » sont faux (sondes de sécurité, scrapers). Deux méthodes fiables :
- **Liste d'IP officielle** (Google, Bing, OpenAI, Perplexity) : l'IP doit appartenir à l'un des blocs publiés. C'est la méthode utilisée par `--verify`.
- **DNS inverse confirmé** (Google, Bing, Apple, Yandex, Baidu) : `host <ip>` doit donner un nom du domaine de l'éditeur, et ce nom doit pointer à nouveau vers la même IP. Le script le fait pour les `--dns-limit` IP les plus actives de chaque robot.
Sans méthode publiée (Anthropic, Meta, Amazon…), juger au comportement : un robot IA qui demande surtout des adresses en 404 ou des chemins comme `/.env` est presque toujours un imposteur.
Derrière un CDN (Cloudflare ou autre), l'IP du journal est celle du CDN : toute vérification est fausse tant que le serveur n'enregistre pas l'IP réelle (module `real_ip` de nginx avec l'en-tête du CDN, ou `mod_remoteip` d'Apache).
## 4. Recettes robots.txt
Être cité par les IA sans nourrir leur entraînement :
```
User-agent: GPTBot
User-agent: ClaudeBot
User-agent: CCBot
User-agent: Bytespider
User-agent: meta-externalagent
User-agent: Google-Extended
User-agent: Applebot-Extended
Disallow: /
User-agent: OAI-SearchBot
User-agent: Claude-SearchBot
User-agent: PerplexityBot
Allow: /
```
Ralentir les outils SEO sans les couper (Crawl-delay est respecté par Ahrefs, Semrush et Majestic, mais ignoré par Googlebot) :
```
User-agent: AhrefsBot
User-agent: SemrushBot
User-agent: MJ12bot
Crawl-delay: 5
```
Ne jamais bloquer dans robots.txt une adresse qu'on veut désindexer : Google ne verrait plus la balise noindex. robots.txt règle l'exploration, pas l'indexation.
## 5. Bloquer ou ralentir au niveau du serveur
robots.txt est une demande polie. Pour les robots qui l'ignorent (section « interdits mais demandés » du rapport) et pour les faux robots, agir dans nginx ou Apache :
- user-agent indésirable : une `map` nginx sur `$http_user_agent` qui renvoie 403 ;
- faux moteurs : bloquer par IP les adresses listées par le rapport, ou limiter le débit (`limit_req`) des requêtes qui se disent Googlebot sans venir des blocs de Google ;
- sondes de sécurité : un 403 ou un 404 sec suffit ; fail2ban sur ces motifs coupe les scanners récurrents.
Toujours tester (`nginx -t`) et laisser Googlebot vérifié hors de toute limitation.
 Fichier 3 : scripts/logbot.py
Le script d'analyse. Python standard, rien à installer.
"""logbot.py : journaux nginx / Apache lus du point de vue SEO et GEO.
Classe chaque requete par robot (moteurs, IA d'entrainement, IA de recherche, IA a la demande
d'un utilisateur, outils SEO, apercus sociaux), demasque les faux robots (listes d'IP officielles
et DNS), mesure le budget de crawl et son gaspillage, regroupe les adresses par gabarit et sort
un rapport Markdown plus un CSV par adresse. Python 3.8+, bibliotheque standard seulement.
Exemples :
python3 logbot.py /var/log/nginx/access.log*
python3 logbot.py access.log*.gz --days 30 --verify --sitemap https://exemple.fr/sitemap.xml
python3 logbot.py logs/*.gz --robots https://exemple.fr/robots.txt --out rapport
"""
import argparse
import collections
import csv
import datetime as dt
import gzip
import io
import ipaddress
import json
import os
import re
import socket
import sys
import urllib.parse
import urllib.request
import urllib.robotparser
import xml.etree.ElementTree as ET
UA_TOOL = "logbot/1.0 (+https://github.com/jaffaars/claude-skills-logbot)"
# --- Robots connus -------------------------------------------------------------------------
# (motif du user-agent, nom, famille, jeton robots.txt, verification)
# Familles : moteur, ia-recherche, ia-utilisateur, ia-entrainement, outil-seo, apercu.
# Verification : "ip:<cle>" = liste d'IP officielle (IP_LISTS), "dns:<domaines>" = DNS inverse confirme.
# Le premier motif qui correspond gagne : les plus precis sont en tete.
G_DNS = "dns:googlebot.com,google.com,googleusercontent.com"
BOTS = [
(r"Googlebot-Image", "Googlebot-Image", "moteur", "Googlebot-Image", "ip:google"),
(r"Googlebot-Video", "Googlebot-Video", "moteur", "Googlebot-Video", "ip:google"),
(r"Googlebot-News", "Googlebot-News", "moteur", "Googlebot-News", "ip:google"),
(r"Storebot-Google", "Storebot-Google", "moteur", "Storebot-Google", "ip:google"),
(r"Google-InspectionTool", "Google-InspectionTool", "moteur", "Googlebot", "ip:google"),
(r"GoogleOther", "GoogleOther", "moteur", "GoogleOther", "ip:google"),
(r"Google-CloudVertexBot", "Google-CloudVertexBot", "ia-entrainement", "Google-CloudVertexBot", "ip:google"),
(r"AdsBot-Google", "AdsBot-Google", "moteur", "AdsBot-Google", "ip:google"),
(r"Googlebot", "Googlebot", "moteur", "Googlebot", "ip:google"),
(r"bingbot|BingPreview", "Bingbot", "moteur", "bingbot", "ip:bing"),
(r"YandexBot|YandexImages", "YandexBot", "moteur", "Yandex", "dns:yandex.ru,yandex.net,yandex.com"),
(r"Baiduspider", "Baiduspider", "moteur", "Baiduspider", "dns:baidu.com,baidu.jp"),
(r"DuckDuckBot", "DuckDuckBot", "moteur", "DuckDuckBot", ""),
(r"Qwantbot|Qwantify", "Qwantbot", "moteur", "Qwantbot", ""),
(r"SeznamBot", "SeznamBot", "moteur", "SeznamBot", ""),
(r"Applebot", "Applebot", "moteur", "Applebot", "dns:applebot.apple.com"),
(r"PetalBot", "PetalBot", "moteur", "PetalBot", ""),
(r"OAI-SearchBot", "OAI-SearchBot", "ia-recherche", "OAI-SearchBot", "ip:openai-search"),
(r"ChatGPT-User", "ChatGPT-User", "ia-utilisateur", "ChatGPT-User", "ip:openai-user"),
(r"GPTBot", "GPTBot", "ia-entrainement", "GPTBot", "ip:openai-gptbot"),
(r"Claude-SearchBot", "Claude-SearchBot", "ia-recherche", "Claude-SearchBot", ""),
(r"Claude-User", "Claude-User", "ia-utilisateur", "Claude-User", ""),
(r"ClaudeBot|anthropic-ai|Claude-Web", "ClaudeBot", "ia-entrainement", "ClaudeBot", ""),
(r"Perplexity-User", "Perplexity-User", "ia-utilisateur", "Perplexity-User", "ip:perplexity-user"),
(r"PerplexityBot", "PerplexityBot", "ia-recherche", "PerplexityBot", "ip:perplexity-bot"),
(r"MistralAI-User", "MistralAI-User", "ia-utilisateur", "MistralAI-User", ""),
(r"DuckAssistBot", "DuckAssistBot", "ia-utilisateur", "DuckAssistBot", ""),
(r"YouBot", "YouBot", "ia-recherche", "YouBot", ""),
(r"meta-externalfetcher", "Meta-ExternalFetcher", "ia-utilisateur", "meta-externalfetcher", ""),
(r"meta-externalagent", "Meta-ExternalAgent", "ia-entrainement", "meta-externalagent", ""),
(r"Amazonbot", "Amazonbot", "ia-entrainement", "Amazonbot", ""),
(r"Bytespider", "Bytespider", "ia-entrainement", "Bytespider", ""),
(r"CCBot", "CCBot", "ia-entrainement", "CCBot", ""),
(r"cohere-ai|cohere-training-data-crawler", "Cohere", "ia-entrainement", "cohere-ai", ""),
(r"Diffbot", "Diffbot", "ia-entrainement", "Diffbot", ""),
(r"AI2Bot", "AI2Bot", "ia-entrainement", "AI2Bot", ""),
(r"AhrefsBot|AhrefsSiteAudit", "AhrefsBot", "outil-seo", "AhrefsBot", ""),
(r"SemrushBot|SiteAuditBot", "SemrushBot", "outil-seo", "SemrushBot", ""),
(r"MJ12bot", "MJ12bot", "outil-seo", "MJ12bot", ""),
(r"DotBot", "DotBot", "outil-seo", "DotBot", ""),
(r"BLEXBot", "BLEXBot", "outil-seo", "BLEXBot", ""),
(r"DataForSeoBot", "DataForSeoBot", "outil-seo", "DataForSeoBot", ""),
(r"Screaming Frog", "Screaming Frog", "outil-seo", "Screaming Frog SEO Spider", ""),
(r"SEOkicks", "SEOkicks", "outil-seo", "SEOkicks", ""),
(r"Barkrowler", "Barkrowler", "outil-seo", "Barkrowler", ""),
(r"facebookexternalhit|Facebot", "Facebook (apercu)", "apercu", "facebookexternalhit", ""),
(r"Twitterbot", "Twitterbot", "apercu", "Twitterbot", ""),
(r"LinkedInBot", "LinkedInBot", "apercu", "LinkedInBot", ""),
(r"Slackbot", "Slackbot", "apercu", "Slackbot", ""),
(r"Discordbot", "Discordbot", "apercu", "Discordbot", ""),
(r"TelegramBot", "TelegramBot", "apercu", "TelegramBot", ""),
(r"WhatsApp", "WhatsApp", "apercu", "WhatsApp", ""),
]
IP_LISTS = {
"google": ["https://developers.google.com/static/search/apis/ipranges/googlebot.json",
"https://developers.google.com/static/search/apis/ipranges/special-crawlers.json",
"https://developers.google.com/static/search/apis/ipranges/user-triggered-fetchers.json"],
"bing": ["https://www.bing.com/toolbox/bingbot.json"],
"openai-gptbot": ["https://openai.com/gptbot.json"],
"openai-search": ["https://openai.com/searchbot.json"],
"openai-user": ["https://openai.com/chatgpt-user.json"],
"perplexity-bot": ["https://www.perplexity.ai/perplexitybot.json"],
"perplexity-user": ["https://www.perplexity.ai/perplexity-user.json"],
}
BOT_RE = [(re.compile(p, re.I), n, f, t, v) for p, n, f, t, v in BOTS]
GENERIC_BOT = re.compile(r"bot|crawl|spider|slurp|fetch|scan|curl|wget|python|go-http|java/|libwww|httpclient|headless|axios|node-fetch|okhttp|scrapy|zgrab|masscan", re.I)
FAMILIES = ["moteur", "ia-recherche", "ia-utilisateur", "ia-entrainement", "outil-seo", "apercu", "faux-robot", "autre-robot", "humain-probable"]
FAMILY_LABEL = {
"moteur": "Moteurs de recherche", "ia-recherche": "IA : index de recherche", "ia-utilisateur": "IA : lecture à la demande d'un utilisateur",
"ia-entrainement": "IA : entraînement", "outil-seo": "Outils SEO", "apercu": "Aperçus sociaux",
"faux-robot": "Robots usurpés (faux moteurs, fausses IA)", "autre-robot": "Autres robots et scripts",
"humain-probable": "Navigateurs (humains probables)",
}
LINE_RE = re.compile(r'^(\S+) \S+ \S+ \[([^\]]+)\] "([A-Z]+) (\S+)[^"]*" (\d{3}) (\S+)(?: "([^"]*)" "([^"]*)")?')
STATIC_RE = re.compile(r"\.(css|js|mjs|map|png|jpe?g|gif|webp|avif|svg|ico|woff2?|ttf|eot|otf|mp4|webm|mp3|pdf|zip|gz)$", re.I)
PROBE_RE = re.compile(r"/\.(env|git|svn|aws|ssh|htpasswd|DS_Store|turbo|changeset|vscode|idea|github)\b|(^|/)wp-(login|admin|config|includes|content)|(^|/)xmlrpc\.php|phpmyadmin|(^|/)pma/|adminer|(^|/)vendor/|phpunit|eval-stdin|cgi-bin|(^|/)actuator|(^|/)_profiler|(^|/)telescope|(^|/)config/|(^|/)(lerna|rush|composer|package|tsconfig|config|settings|credentials|secrets)\.json$|\.(sql|bak|old|swp|env|ya?ml|toml|ini|log)$|(^|/)\.well-known/.*\.php|(^|/)api/account|(^|/).(dockerenv|dev.vars)$|(^|/)auth.json$|/v\d+/auth/|(^|/)boaform|(^|/)HNAP1|(^|/)owa/|(^|/)solr/|(^|/)server-status", re.I)
# Fichiers techniques : comptes a part, jamais dans les classements de pages
INFRA_RE = re.compile(r"^/(robots\.txt|ads\.txt|app-ads\.txt|humans\.txt|security\.txt|llms(-full)?\.txt|favicon\.ico|sitemap[^/]*|\.well-known/.*)$", re.I)
TRACKING = re.compile(r"^(utm_\w+|fbclid|gclid|msclkid|yclid|_ga|_gl|mc_cid|mc_eid|ref|ref_src|igshid|sid|phpsessid|sessionid|jsessionid)$", re.I)
def n(x):
return f"{x:,}".replace(",", " ")
def pct(a, b):
return f"{100.0 * a / b:.1f} %" if b else "0 %"
def classify(ua):
for rx, name, family, token, verif in BOT_RE:
if rx.search(ua):
return name, family, token, verif
if not ua or ua == "-" or GENERIC_BOT.search(ua):
return "Autre robot", "autre-robot", None, ""
return "Navigateur", "humain-probable", None, ""
def open_log(path):
if path.endswith(".gz"):
return io.TextIOWrapper(gzip.open(path, "rb"), encoding="utf-8", errors="replace")
return open(path, encoding="utf-8", errors="replace")
def url_key(target):
"""Adresse de reference : chemin decode + parametres utiles tries (pistage et session retires)."""
parts = urllib.parse.urlsplit(target)
path = urllib.parse.unquote(parts.path or "/")
path = path if path == "/" else (path.rstrip("/") or "/")
params = [(k, v) for k, v in urllib.parse.parse_qsl(parts.query, keep_blank_values=True)]
tracked = any(TRACKING.match(k) for k, _ in params)
kept = sorted((k, v) for k, v in params if not TRACKING.match(k))
key = path + ("?" + urllib.parse.urlencode(kept) if kept else "")
return key, path, bool(params), tracked
def template(key):
"""Gabarit d'adresse : chiffres remplaces, slug coupe, valeurs de parametres masquees."""
path, _, query = key.partition("?")
path = re.sub(r"\d+", "{n}", path)
path = re.sub(r"(\{n\})[-_][^/]*?(\.[a-z0-9]+)?$", r"\1-...\2", path)
if query:
names = sorted({p.split("=")[0] for p in query.split("&")})
path += "?" + "&".join(f"{k}=*" for k in names)
return path
def fetch(url, timeout=20):
req = urllib.request.Request(url, headers={"User-Agent": UA_TOOL})
return urllib.request.urlopen(req, timeout=timeout).read()
def load_ip_lists(keys):
nets, status = {}, {}
for key in keys:
nets[key] = []
for url in IP_LISTS[key]:
try:
data = json.loads(fetch(url))
for p in data.get("prefixes", []):
cidr = p.get("ipv4Prefix") or p.get("ipv6Prefix")
if cidr:
nets[key].append(ipaddress.ip_network(cidr, strict=False))
status[url] = "ok"
except Exception as exc:
status[url] = f"indisponible ({exc.__class__.__name__})"
return nets, status
def in_nets(ip, nets):
try:
addr = ipaddress.ip_address(ip)
except ValueError:
return False
return any(addr in net for net in nets if net.version == addr.version)
def dns_ok(ip, domains, cache):
"""DNS inverse puis confirmation directe (methode documentee par Google, Bing, Apple, Yandex)."""
if ip not in cache:
try:
host = socket.gethostbyaddr(ip)[0].lower().rstrip(".")
good = any(host == d or host.endswith("." + d) for d in domains)
cache[ip] = good and ip in {a[4][0] for a in socket.getaddrinfo(host, None)}
except Exception:
cache[ip] = False
return cache[ip]
def load_sitemap(src, limit=100000):
seen, todo, keys = set(), [src], set()
while todo and len(keys) < limit:
cur = todo.pop()
if cur in seen:
continue
seen.add(cur)
try:
data = fetch(cur) if re.match(r"https?://", cur) else open(cur, "rb").read()
if data[:2] == b"\x1f\x8b":
data = gzip.decompress(data)
root = ET.fromstring(data)
except Exception as exc:
print(f"sitemap illisible : {cur} ({exc})", file=sys.stderr)
continue
is_index = root.tag.endswith("sitemapindex")
for el in root.iter():
if el.tag.endswith("loc") and el.text:
loc = el.text.strip()
if is_index:
todo.append(loc)
else:
sp = urllib.parse.urlsplit(loc)
keys.add(url_key(sp.path + ("?" + sp.query if sp.query else ""))[0])
return keys
def main():
if hasattr(sys.stdout, "reconfigure"):
sys.stdout.reconfigure(encoding="utf-8")
ap = argparse.ArgumentParser(description="Analyse SEO et GEO de journaux nginx / Apache (format combined).")
ap.add_argument("logs", nargs="+", help="fichiers de journaux (.log, .gz)")
ap.add_argument("--days", type=int, default=0, help="ne garder que les N derniers jours (0 = tout)")
ap.add_argument("--verify", action="store_true", help="démasquer les faux robots (listes d'IP officielles + DNS)")
ap.add_argument("--dns-limit", type=int, default=100, help="IP vérifiées par DNS pour chaque robot sans liste d'IP (défaut 100)")
ap.add_argument("--sitemap", help="URL ou fichier du sitemap (adresses jamais vues par Googlebot)")
ap.add_argument("--robots", help="URL ou fichier robots.txt (robots qui passent outre)")
ap.add_argument("--top", type=int, default=15, help="taille des classements (défaut 15)")
ap.add_argument("--out", help="dossier de sortie (rapport.md + adresses.csv) ; sinon rapport sur la sortie standard")
args = ap.parse_args()
files = [f for f in args.logs if os.path.isfile(f)]
if not files:
sys.exit("Aucun fichier de journal lisible.")
bad = 0
def entries():
"""Lecture au fil de l'eau : un journal de plusieurs centaines de Mo ne tient pas en memoire."""
nonlocal bad
for path in files:
with open_log(path) as fh:
for line in fh:
m = LINE_RE.match(line)
if not m:
bad += 1
continue
ip, ts, method, target, status, size, _ref, ua = m.groups()
try:
when = dt.datetime.strptime(ts, "%d/%b/%Y:%H:%M:%S %z")
except ValueError:
bad += 1
continue
yield when, ip, method, target, int(status), size, ua or "-"
# Premier passage (seulement si utile) : date la plus recente et IP par robot verifiable
limit = None
verdict = {} # (robot, ip) -> True authentique / False usurpe / None non verifie
ip_status = {}
if args.days or args.verify:
newest = None
ips_by_bot = collections.defaultdict(collections.Counter)
for when, ip, _m, _t, _s, _z, ua in entries():
newest = when if newest is None or when > newest else newest
if args.verify:
name, _f, _t2, verif = classify(ua)
if verif:
ips_by_bot[(name, verif)][ip] += 1
bad = 0
if args.days and newest:
limit = newest - dt.timedelta(days=args.days)
if args.verify:
keys = {v[3:] for (_n, v) in ips_by_bot if v.startswith("ip:")}
nets, ip_status = load_ip_lists(keys)
cache = {}
for (name, verif), ips in ips_by_bot.items():
if verif.startswith("ip:"):
lst = nets.get(verif[3:]) or []
for ip in ips:
verdict[(name, ip)] = in_nets(ip, lst) if lst else None
else:
domains = verif[4:].split(",")
for ip, _c in ips.most_common(args.dns_limit):
verdict[(name, ip)] = dns_ok(ip, domains, cache)
# Agregats
total = 0
first = last = None
fam_hits = collections.Counter()
mk = lambda: {"hits": 0, "family": "", "token": None, "status": collections.Counter(), "urls": collections.Counter(),
"static": 0, "params": 0, "tracked": 0, "days": collections.Counter(), "last": None, "unverified": 0}
bot = collections.defaultdict(mk)
url_bot = collections.defaultdict(collections.Counter)
url_status_g = collections.defaultdict(collections.Counter)
url_last_g = {}
tpl = collections.defaultdict(collections.Counter) # famille -> gabarit -> hits
infra = collections.defaultdict(collections.Counter) # fichier technique -> famille -> hits
probes = collections.defaultdict(collections.Counter) # famille -> chemin sonde -> hits
for when, ip, method, target, status, size, ua in entries():
if limit and when < limit:
continue
total += 1
first = when if first is None or when < first else first
last = when if last is None or when > last else last
name, family, token, verif = classify(ua)
v = verdict.get((name, ip)) if verif else True
if v is False:
name, family = "Faux " + name, "faux-robot"
key, path, has_params, tracked = url_key(target)
if PROBE_RE.search(path):
probes[family][path] += 1
fam_hits[family] += 1
bot[name]["hits"] += 0
continue
fam_hits[family] += 1
is_infra = bool(INFRA_RE.match(path))
is_static = is_infra or bool(STATIC_RE.search(path))
if is_infra:
infra["/sitemap*" if path.lower().startswith("/sitemap") else path.lower()][family] += 1
b = bot[name]
b["hits"] += 1
b["family"], b["token"] = family, token
b["status"][status] += 1
b["days"][when.date().isoformat()] += 1
b["last"] = when if b["last"] is None or when > b["last"] else b["last"]
if args.verify and ((verif and v is None) or (not verif and family.startswith("ia-"))):
b["unverified"] += 1
if has_params:
b["params"] += 1
if tracked:
b["tracked"] += 1
if is_static:
b["static"] += 1
continue
b["urls"][key] += 1
if family != "humain-probable":
url_bot[key][name] += 1
tpl[family][template(key)] += 1
if name == "Googlebot":
url_last_g[key] = max(url_last_g.get(key, when), when)
url_status_g[key][status] += 1
# robots.txt
violations = []
if args.robots:
rp = urllib.robotparser.RobotFileParser()
try:
text = fetch(args.robots).decode("utf-8", "replace") if re.match(r"https?://", args.robots) else open(args.robots, encoding="utf-8", errors="replace").read()
rp.parse(text.splitlines())
for name, b in bot.items():
if b["token"] and b["family"] not in ("apercu", "faux-robot", "ia-utilisateur"):
blocked = [(u, c) for u, c in b["urls"].items() if not rp.can_fetch(b["token"], u)]
if blocked:
violations.append((name, b["family"], sum(c for _, c in blocked), len(blocked), sorted(blocked, key=lambda x: -x[1])[:3]))
except Exception as exc:
print(f"robots.txt illisible : {exc}", file=sys.stderr)
sitemap = load_sitemap(args.sitemap) if args.sitemap else set()
# --- Rapport ----------------------------------------------------------------------------
out = []
w = out.append
days = max(1, (last - first).days + 1) if first else 1
code_share = lambda s, lo, hi: sum(c for k, c in s.items() if lo <= k < hi)
w("# Analyse des journaux : SEO et GEO\n")
if not first:
w("Aucune ligne exploitable.")
print("\n".join(out))
return
w(f"- Période : du {first:%d/%m/%Y %H:%M} au {last:%d/%m/%Y %H:%M} ({days} jour{'s' if days > 1 else ''})")
w(f"- Requêtes analysées : {n(total)}" + (f" ; lignes illisibles : {n(bad)}" if bad else ""))
w(f"- Fichiers : {len(files)}")
if args.verify:
failed = [u for u, s in ip_status.items() if s != "ok"]
w("- Vérification des robots : listes d'IP officielles et DNS" + (f" ; listes indisponibles : {', '.join(failed)}" if failed else ""))
else:
w("- Vérification des robots : non faite (option --verify) ; les chiffres incluent les faux robots")
w("")
w("## 1. Qui consomme le serveur\n")
w("| Famille | Requêtes | Part | Par jour |")
w("|---|---:|---:|---:|")
for f in FAMILIES:
if fam_hits[f]:
w(f"| {FAMILY_LABEL[f]} | {n(fam_hits[f])} | {pct(fam_hits[f], total)} | {n(fam_hits[f] // days)} |")
w("")
w("## 2. Robots identifiés\n")
w("| Robot | Famille | Requêtes | Pages | Ressources | 3xx | 4xx | 5xx | Pistage | Non vérifié | Dernier passage |")
w("|---|---|---:|---:|---:|---:|---:|---:|---:|---:|---|")
named = sorted(((k, b) for k, b in bot.items() if b["family"] not in ("humain-probable", "") and b["hits"]), key=lambda x: -x[1]["hits"])
for name, b in named[: max(args.top * 2, 30)]:
s, h = b["status"], b["hits"]
w(f"| {name} | {b['family']} | {n(h)} | {n(h - b['static'])} | {n(b['static'])} | {pct(code_share(s, 300, 400), h)} | {pct(code_share(s, 400, 500), h)} | {pct(code_share(s, 500, 600), h)} | {pct(b['tracked'], h)} | {pct(b['unverified'], h) if b['unverified'] else '-'} | {b['last']:%d/%m %H:%M} |")
w("\nPages = documents HTML ; Ressources = CSS, JS, images et fichiers techniques ; Pistage = paramètres de suivi ou de session ; Non vérifié = requêtes dont l'IP n'a pas pu être contrôlée (robot sans liste officielle, ou IP au-delà de --dns-limit).")
w("")
fakes =[(k, b) for k, b in bot.items() if b["family"] == "faux-robot" and b["hits"]]
if args.verify:
w("## 3. Faux robots\n")
if fakes:
w("Requêtes dont le user-agent annonce un moteur ou une IA, depuis une IP qui ne lui appartient pas :\n")
for k, b in sorted(fakes, key=lambda x: -x[1]["hits"]):
w(f"- {k} : {n(b['hits'])} requêtes, 4xx {pct(code_share(b['status'], 400, 500), b['hits'])}")
w("\nCes requêtes sont sorties des familles d'origine : les chiffres des sections suivantes ne concernent que les vrais robots.")
else:
w("Aucun faux robot parmi les IP vérifiées.")
w("")
g = bot.get("Googlebot")
w("## 4. Budget de crawl de Googlebot\n")
if g and g["hits"]:
s, h = g["status"], g["hits"]
pages = h - g["static"]
r3, r4, r5 = code_share(s, 300, 400), code_share(s, 400, 500), code_share(s, 500, 600)
w(f"- {n(h)} requêtes en {days} jour{'s' if days > 1 else ''}, soit {n(h // days)} par jour : {n(pages)} pages et {n(g['static'])} ressources")
w(f"- {n(len(g['urls']))} adresses de pages distinctes ; {pct(g['params'], h)} des requêtes portent des paramètres")
w(f"- Gaspillage certain : {pct(r3 + r4 + r5 + g['tracked'], h)} (redirections {pct(r3, h)}, 4xx {pct(r4, h)}, 5xx {pct(r5, h)}, paramètres de pistage ou de session {pct(g['tracked'], h)})")
freq = collections.Counter(min(c, 10) for c in g["urls"].values())
w(f"- Fréquence : {n(freq[1])} pages vues une fois, {n(sum(c for k, c in freq.items() if 2 <= k < 10))} de 2 à 9 fois, {n(freq[10])} 10 fois ou plus\n")
w("Gabarits les plus crawlés par Googlebot :\n")
gt = collections.Counter(template(u) for u in g["urls"].elements())
for t, c in gt.most_common(args.top):
w(f"- {c:>6} {t[:110]}")
w("\nPages les plus crawlées :\n")
for u, c in g["urls"].most_common(args.top):
w(f"- {c:>6} {u[:110]}")
errs = []
for u, st in url_status_g.items():
bad_codes = {k: c for k, c in st.items() if k >= 400 or 300 <= k < 400}
if bad_codes:
code, c = max(bad_codes.items(), key=lambda x: x[1])
errs.append((u, sum(bad_codes.values()), code))
if errs:
w("\nAdresses en redirection ou en erreur les plus demandées :\n")
for u, c, code in sorted(errs, key=lambda x: -x[1])[: args.top]:
w(f"- {c:>6} {code} {u[:110]}")
days_list = sorted(g["days"].items())
if len(days_list) > 1:
w("\nPar jour : " + " ; ".join(f"{d[8:]}/{d[5:7]} {c}" for d, c in days_list[-31:]))
else:
w("Aucune requête de Googlebot dans la période.")
w("")
if sitemap:
crawled = set(url_last_g)
seen = sitemap & crawled
never = sitemap - crawled
outside = [u for u in crawled if u not in sitemap]
w("## 5. Sitemap et crawl de Googlebot\n")
w(f"- Adresses du sitemap : {n(len(sitemap))} ; vues par Googlebot dans la période : {n(len(seen))} ({pct(len(seen), len(sitemap))})")
nt = collections.Counter(template(u) for u in never)
w(f"- Jamais vues : {n(len(never))}. Par gabarit : " + ", ".join(f"{t} ({c})" for t, c in nt.most_common(6)))
ot = collections.Counter()
for u in outside:
ot[template(u)] += sum(url_bot[u].values())
w(f"- Crawlées hors sitemap : {n(len(outside))} adresses. Gabarits les plus demandés : " + ", ".join(f"{t} ({c})" for t, c in ot.most_common(6)))
w("")
w("## 6. GEO : ce que lisent les IA\n")
for fam in ("ia-utilisateur", "ia-recherche", "ia-entrainement"):
group = [(k, b) for k, b in bot.items() if b["family"] == fam and b["hits"]]
hits = sum(b["hits"] for _, b in group)
w(f"### {FAMILY_LABEL[fam]} : {n(hits)} requêtes\n")
if not hits:
w("Aucune.\n")
continue
for k, b in sorted(group, key=lambda x: -x[1]["hits"]):
r4 = code_share(b["status"], 400, 500) / max(1, b["hits"])
extra = (", IP non vérifiable" if b["unverified"] else "") + (" ; taux de 4xx anormal, probablement usurpé en partie" if r4 > 0.3 else "")
w(f"- {k} : {n(b['hits'])} requêtes, {n(len(b['urls']))} pages, 4xx {pct(code_share(b['status'], 400, 500), b['hits'])}{extra}")
top = collections.Counter()
for _k, b in group:
top.update(b["urls"])
w("\nPages les plus lues :\n")
for u, c in top.most_common(args.top):
w(f"- {c:>6} {u[:110]}")
w("\nGabarits les plus lus : " + ", ".join(f"{t} ({c})" for t, c in tpl[fam].most_common(8)))
w("")
if violations:
w("## 7. robots.txt : interdits mais demandés\n")
for name, fam, hits, cnt, ex in sorted(violations, key=lambda x: -x[2]):
w(f"- {name} ({fam}) : {n(hits)} requêtes sur {n(cnt)} adresses interdites, par exemple " + ", ".join(u[:60] for u, _ in ex))
w("")
if infra:
w("## 8. Fichiers techniques\n")
for f_name, by_fam in sorted(infra.items(), key=lambda x: -sum(x[1].values()))[:12]:
w(f"- {f_name} : {n(sum(by_fam.values()))} requêtes (" + ", ".join(f"{FAMILY_LABEL[k]} {c}" for k, c in by_fam.most_common(4)) + ")")
if not any(k.startswith("/llms") for k in infra):
w("- /llms.txt : aucune requête dans la période")
w("")
if probes:
w("## 9. Sondes de sécurité (chemins d'attaque connus)\n")
for fam in FAMILIES:
if probes[fam]:
w(f"- {FAMILY_LABEL[fam]} : {n(sum(probes[fam].values()))} requêtes, par exemple " + ", ".join(p[:40] for p, _ in probes[fam].most_common(4)))
w("\nCes requêtes sont exclues des classements de pages ci-dessus.")
w("")
report = "\n".join(out)
if args.out:
os.makedirs(args.out, exist_ok=True)
with open(os.path.join(args.out, "rapport.md"), "w", encoding="utf-8") as fh:
fh.write(report)
cols = [k for k, b in named if b["family"] != "faux-robot"][:20]
with open(os.path.join(args.out, "adresses.csv"), "w", encoding="utf-8", newline="") as fh:
wr = csv.writer(fh, delimiter=";")
wr.writerow(["adresse", "gabarit", "total robots", "dernier Googlebot", "dans le sitemap"] + cols)
for u, c in sorted(url_bot.items(), key=lambda x: -sum(x[1].values())):
lg = url_last_g.get(u)
wr.writerow([u, template(u), sum(c.values()), lg.strftime("%Y-%m-%d") if lg else "", ("oui" if u in sitemap else "non") if sitemap else ""] + [c.get(k, 0) for k in cols])
print(f"Rapport : {os.path.join(args.out, 'rapport.md')}\nAdresses : {os.path.join(args.out, 'adresses.csv')}")
else:
print(report)
if __name__ == "__main__":
main()
Les retours et les améliorations sont les bienvenus, ici ou sur GitHub. Je mettrai le skill à jour dans le dépôt et dans ce sujet 
Hors ligne
Pages : 1
Accueil › Agents et automatisation IA › logbot, le skill Claude qui analyse vos logs SEO / GEO
Haut