#1 script, google, contenu, algorithme, sitemap
Le guide des Quality Raters de Google transformé en script gratuit !
Salut à tous,
Google paie environ 16 000 évaluateurs humains, les Quality Raters, pour noter des pages selon un guide public de plus de 170 pages. Leurs notes ne classent pas votre site directement : elles servent à vérifier que chaque changement d'algorithme va dans le sens de ce guide. Autrement dit, ce document décrit noir sur blanc ce que l'algorithme cherche à récompenser. Presque personne ne le lit en entier.
Je l'ai transformé en grille de notation, puis en script : vous donnez votre site, il crawle les pages et fait noter chacune par une IA, critère par critère, comme le ferait un rater. Gratuit, sans rien installer.
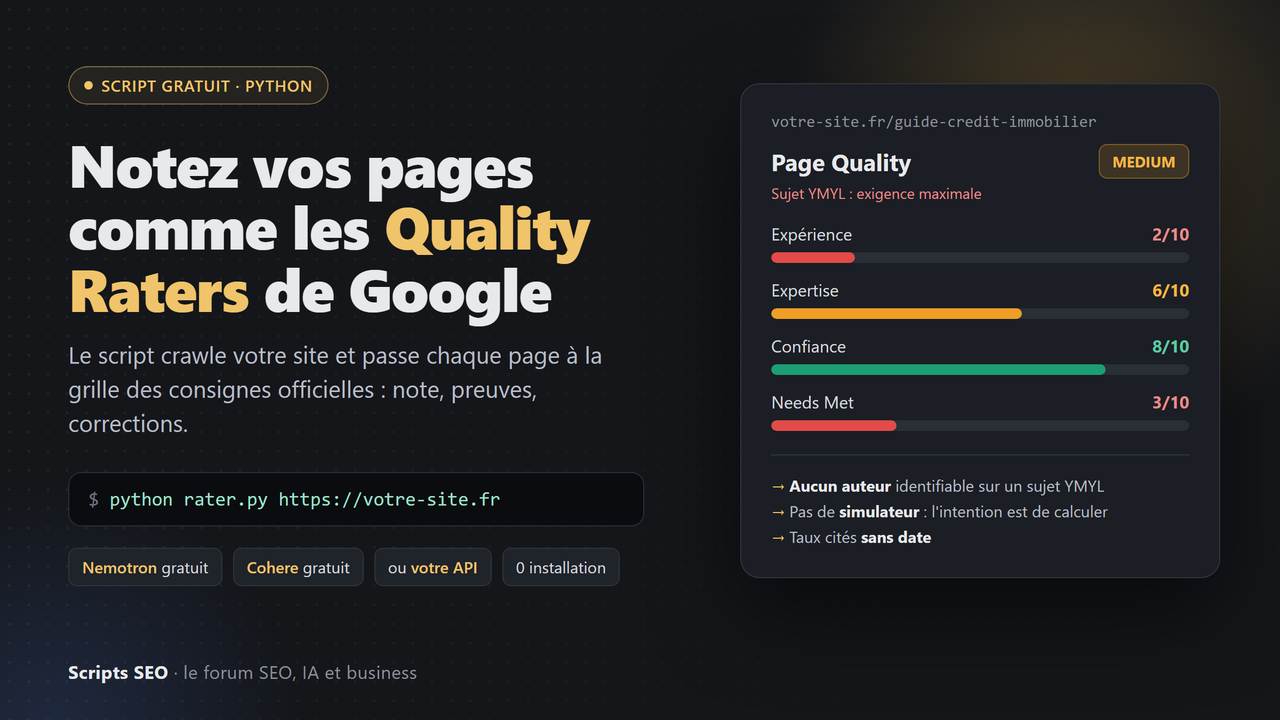
En brefle script lit votre sitemap, extrait le contenu principal de chaque page et le fait noter selon la méthode des Quality Raters (but de la page, YMYL, E-E-A-T, Needs Met). Vous obtenez un rapport classé de la pire page à la meilleure, avec les preuves et les corrections concrètes à faire, page par page. Il marche avec Nemotron (gratuit), Cohere (gratuit) ou votre propre clé d'API.
 Ce que regarde un Quality Rater
Le guide est long, mais la méthode tient en six questions, posées toujours dans le même ordre :
À quoi sert la page ? Une page sans but utile, ou faite pour tromper, est notée Lowest, quel que soit le reste.
Est-ce un sujet YMYL ? « Your Money or Your Life » : santé, argent, sécurité, droit. Plus le risque est élevé pour le lecteur, plus l'exigence de fiabilité monte.
Le contenu principal vaut-il quelque chose ? Effort visible, originalité, savoir-faire. Une reformulation de ce qui existe partout plafonne à Medium.
E-E-A-T : Expérience (vécu de première main), Expertise, Autorité, et surtout Confiance, que le guide place au centre : une page peu fiable ne peut pas être bien notée, même experte.
Needs Met : pour la requête qui mène à la page, la réponse est-elle complète et rapide ?
Signaux Lowest : contenu trompeur, site opaque sur un sujet YMYL, texte produit en masse sans valeur ajoutée, contenu principal quasi vide.
Le point que tout le monde rate : la note n'est pas une moyenne. Un seul critère éliminatoire (la confiance sur un sujet YMYL, par exemple) suffit à faire tomber la page, même si tout le reste est bon.
 Le script : rater.py
Il lit le sitemap (ou suit les liens internes s'il n'y en a pas) et prend un échantillon réparti sur tout le site, pas seulement les premières URL.
Il garde le contenu principal sans menu ni pied de page, et relève les faits que l'IA ne doit pas deviner : auteur trouvé ou non, dates, types Schema.org, pages À propos / Contact / Mentions légales.
Il envoie le tout avec la grille (le prompt est dans le script, lisible et modifiable) et récupère une note structurée.
Il sort rater-report.html (à ouvrir dans le navigateur) et rater-report.csv (pour Excel), de la pire page à la meilleure.
Aucune installation : Python 3.9 ou plus suffit, aucune bibliothèque à ajouter.
 Ce que vous obtenez
Voici le rapport tel que le script le sort, sans retouche. Je l'ai lancé sur le forum lui-même, avec Nemotron : quatre pages tirées au hasard dans le sitemap, dont deux vieux sujets de 2014 et 2015.
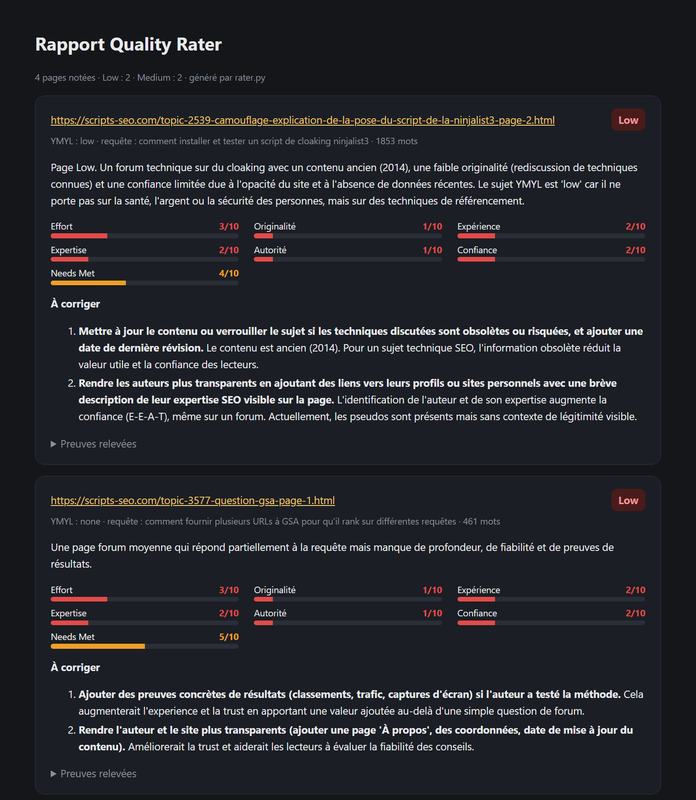
Pour chaque page, de la plus faible à la meilleure :
La note globale (Lowest, Low, Medium, High, Highest), la requête que l'IA pense être visée et le niveau YMYL.
Un verdict en une phrase, et si la note a été abaissée par une règle du guide, la raison est écrite.
Les 7 critères notés sur 10 : Effort, Originalité, Expérience, Expertise, Autorité, Confiance, Needs Met. En rouge sous 4, c'est là qu'il faut agir.
Les corrections à faire, classées par impact, chacune avec sa raison.
Les preuves relevées (à déplier) : ce que l'IA a vu dans la page pour justifier ses notes. Lisez-les avant de corriger.
Le même contenu sort dans rater-report.csv : une ligne par page, à trier dans Excel ou à envoyer à un client.
Ce qu'on lit tout de suite sur cet exemple : les deux vieux sujets tombent en Low faute de date de révision et d'auteurs identifiables, pas à cause du sujet lui-même. Sur un forum comme sur un blog, c'est le même chantier.
Et à quoi ressemble une page bien notée ? Même test sur deux pages de référence : le guide de démarrage SEO de Google et l'article de web.dev sur le LCP.
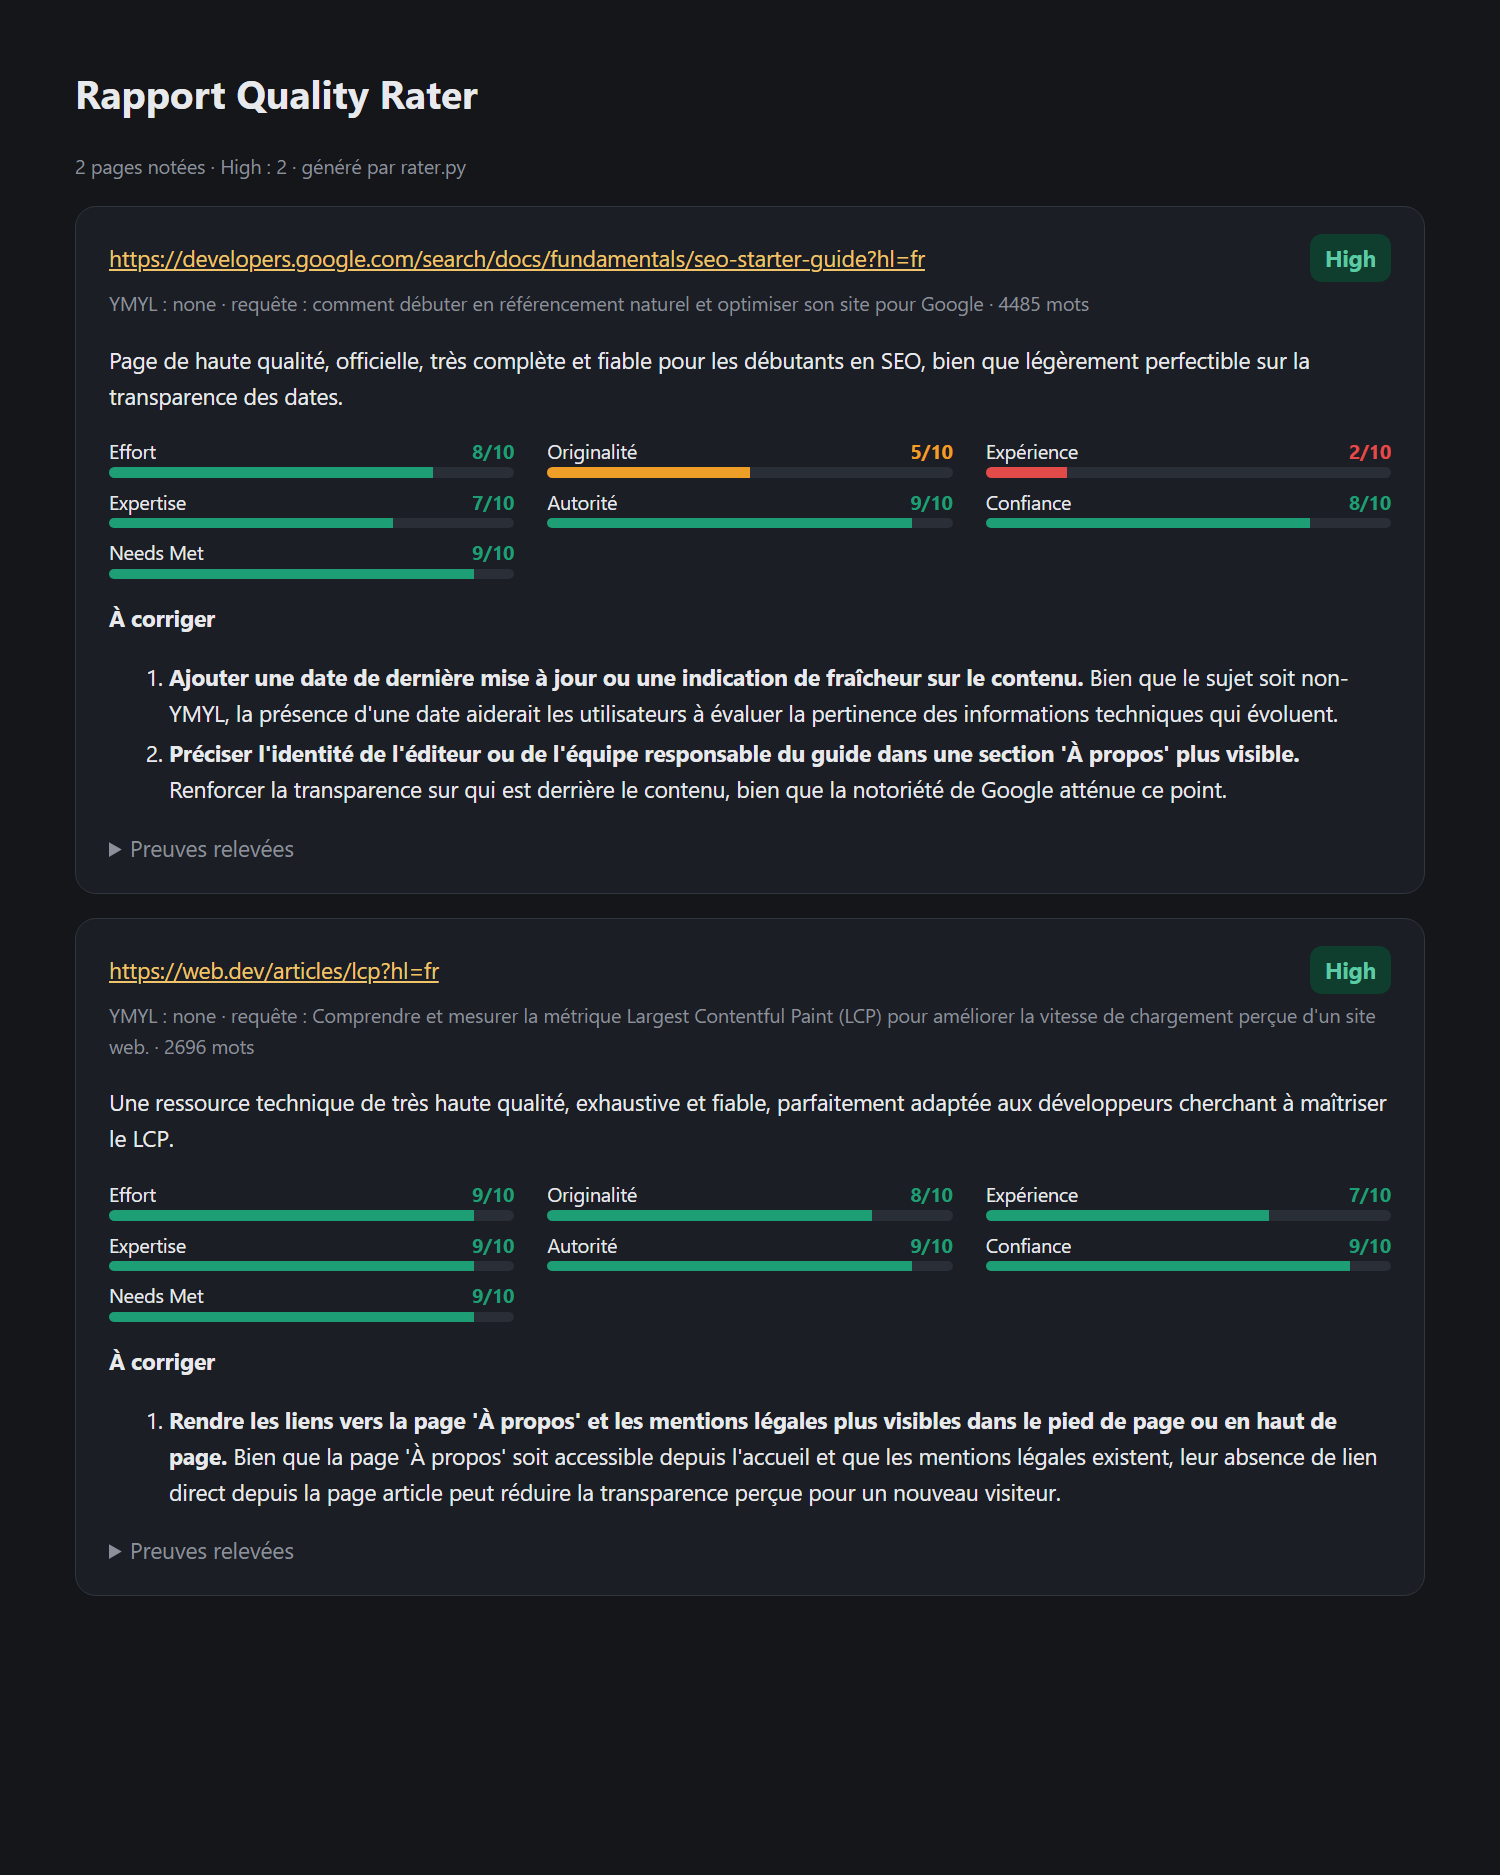
Les deux sortent en High : critères au-dessus de 7, et il ne reste qu'une ou deux corrections de détail.
Même le guide de Google prend 2/10 en Expérience (c'est de la documentation, pas du vécu) et se voit reprocher l'absence de date de mise à jour. C'est l'écart à viser : passer de corrections de fond à des corrections de finition.
 Lancement pas à pas
Récupérez une clé gratuite. Nemotron chez NVIDIA est l'option par défaut (tuto pas à pas sur le Discord, voir plus bas). Cohere marche aussi avec sa clé d'essai gratuite, limitée en nombre d'appels par mois. Dans mes tests, Nemotron tranche davantage : là où Cohere met tout en Medium, il fait ressortir les pages faibles.
Enregistrez le script ci-dessous dans un fichier rater.py.
Déclarez votre clé, puis lancez :
$env:NVIDIA_API_KEY="nvapi-..."
python rater.py https://votre-site.fr
# Mac / Linux
export NVIDIA_API_KEY="nvapi-..."
python3 rater.py https://votre-site.fr
# Cohere à la place de Nemotron
$env:COHERE_API_KEY="..."
python rater.py https://votre-site.fr --ai cohere
# Une ou plusieurs pages précises, sans crawl (ici avec la requête visée)
python rater.py https://votre-site.fr/ma-page --one --query "simulation pret immobilier"
# Votre propre API (toute API compatible OpenAI)
python rater.py https://votre-site.fr --ai custom --base-url https://.../v1 --model nom-du-modele --key ...
 Le dépôt GitHub
Pour récupérer le script directement, suivre les mises à jour ou proposer une amélioration, tout est sur GitHub : github.com/jaffaars/quality-rater.
Le script complet reste aussi ci-dessous, à copier-coller.
Options utiles : --pages 25 pour noter plus de pages (10 par défaut), --pause 5 si votre clé gratuite renvoie des erreurs 429, --out client-x pour nommer le rapport.
 Lire le rapport et corriger dans le bon ordre
Ne corrigez pas page par page dans l'ordre du rapport. Corrigez par type de problème, dans cet ordre :
Les pages Low et Lowest sur un sujet YMYL. Ce sont elles qui coûtent le plus.
La confiance, à l'échelle du site. Si le rapport réclame une page À propos, un auteur ou des dates sur 8 pages sur 10, c'est un seul chantier qui remonte tout le site : auteur réel avec sa page, date de mise à jour visible, sources pour les chiffres, page À propos qui dit qui est derrière.
Needs Met. Répondre dès le haut de la page. Si l'intention est de calculer, comparer ou choisir, un outil ou un tableau vaut mieux que 2 000 mots.
L'originalité. Une donnée à vous, un test, une photo, un cas client : c'est ce qui fait passer de Medium à High.
Exemple réel : j'ai passé mon post sur la citation par ChatGPT au script (avec Cohere). Résultat : Medium, avec Originalité 8/10 et Needs Met 8/10, mais Confiance 4/10 : pas de page À propos sur le site, pas de date de mise à jour, des chiffres sans source. Le contenu est bon, c'est l'enveloppe qui le plombe. Exactement le genre de chose qu'on ne voit plus sur son propre site.
 Les limites, honnêtement
Ce n'est pas la note de Google. C'est une lecture de votre page avec la méthode des raters, par une IA. Elle peut se tromper : lisez les preuves avant de corriger.
Un vrai rater vérifie aussi la réputation du site ailleurs sur le web. Le script ne voit que la page : il juge l'autorité sur les signaux visibles.
Les modèles notent volontiers Medium. Regardez surtout les critères notés sous 4 : ce sont eux qui parlent.
Vos pages sont envoyées au fournisseur d'IA. Ce sont des pages publiques, mais si c'est un problème pour vous, utilisez votre propre API.
 Bonus sur le Discord : Nemotron gratuit
Pour ceux qui veulent un modèle solide sans payer, le post Tips Free AI NVIDIA Nemotron explique comment créer son compte NVIDIA, récupérer sa clé et l'utiliser (dans ce script, mais aussi dans VS Code ou opencode) : le post Nemotron gratuit. Pas encore sur le serveur ? Rejoindre le Discord.
 Postez votre résultat
Lancez-le sur votre site et postez ici votre page la plus mal notée, avec la correction proposée. On verra vite quels problèmes reviennent partout, et je pourrai affiner la grille avec vos retours.
Le script complet (rater.py)
"""
rater.py : notez vos pages comme les Quality Raters de Google.
Crawl du site (sitemap ou liens internes), extraction du contenu principal,
puis notation de chaque page par un modele d'IA selon une grille inspiree
des consignes publiques des Quality Raters (Search Quality Rater Guidelines).
Aucune dependance : Python 3.9+ suffit.
set NVIDIA_API_KEY=nvapi-... (Windows) export NVIDIA_API_KEY=... (Mac/Linux)
python rater.py https://votre-site.fr
python rater.py https://votre-site.fr --ai cohere --pages 10
python rater.py https://votre-site.fr/une-page --one
Fournisseurs : nemotron (NVIDIA, gratuit), cohere (cle d'essai gratuite),
openai, ou toute API compatible OpenAI avec --base-url et --model.
Sorties : rater-report.html (a ouvrir dans le navigateur) et rater-report.csv.
"""
import argparse, csv, html, json, os, re, sys, time
import urllib.request, urllib.error
from html.parser import HTMLParser
from urllib.parse import urljoin, urlparse, urldefrag
import xml.etree.ElementTree as ET
PROVIDERS = {
"nemotron": ("https://integrate.api.nvidia.com/v1", "nvidia/nemotron-3.5-lightning-30b-a3b", "NVIDIA_API_KEY"),
"cohere": ("https://api.cohere.ai/compatibility/v1", "command-a-03-2025", "COHERE_API_KEY"),
"openai": ("https://api.openai.com/v1", "gpt-4.1-mini", "OPENAI_API_KEY"),
}
UA = "Mozilla/5.0 (compatible; rater.py; +https://scripts-seo.com)"
SKIP_EXT = re.compile(r"\.(jpe?g|png|gif|webp|svg|pdf|zip|mp4|mp3|css|js|xml|ico)$", re.I)
GRID = """Tu es un evaluateur de la qualite des pages (Page Quality rater) qui applique la methode des consignes publiques de Google pour ses Quality Raters. Tu notes une page web a partir de son contenu extrait. Sois exigeant, factuel, et appuie chaque note sur un element visible de la page. Pas de complaisance : une page moyenne est notee Medium.
Methode, dans cet ordre :
1. But de la page : a quoi sert-elle ? Une page sans but utile, ou faite pour tromper, est Lowest.
2. Niveau YMYL : le sujet peut-il nuire a la sante, l'argent, la securite ou la vie d'une personne si l'information est fausse ? (none, low, high). Plus le YMYL est eleve, plus l'exigence de fiabilite est haute.
3. Contenu principal (MC) :
- effort : travail humain visible, soin, profondeur, mise en forme utile (0-10)
- originality : apport propre (donnees, test, avis, exemples, outil) et non une reformulation de ce qui existe deja partout (0-10)
4. E-E-A-T :
- experience : vecu de premiere main visible (test, photos, cas reels, "j'ai"...) (0-10)
- expertise : exactitude, precision, maitrise du sujet (0-10)
- authority : la page ou le site est-il une reference reconnue sur ce sujet ? Juge avec les signaux visibles seulement (0-10)
- trust : le plus important. Auteur identifiable, sources, dates, transparence (qui est derriere le site, contact), absence de promesses trompeuses, publicite qui ne gene pas la lecture (0-10)
5. needs_met : pour la requete la plus probable qui mene a cette page (inferred_query), a quel point la page y repond-elle completement et rapidement ? (0-10)
6. Signaux de note Lowest : contenu trompeur, auteur et site totalement opaques sur un sujet YMYL, texte genere en masse sans valeur ajoutee, copie, contenu principal quasi vide.
Note globale (pq_rating) : Lowest, Low, Medium, High ou Highest. High demande un contenu de qualite ET une fiabilite claire. Highest est rare : contenu exceptionnel et reputation forte. Coherence obligatoire : sujet YMYL high avec trust inferieur a 4 = Low au mieux ; un signal Lowest = Lowest.
Corrections : 3 a 5 (jamais moins de 3), concretes, faisables sur la page, classees par impact. Pas de conseils generiques ("ameliorez votre contenu").
lowest_signals : seulement les signaux graves de l'etape 6 (tromperie, copie, contenu vide, masse generee, opacite sur un sujet YMYL). Une simple faiblesse (pas d'auteur sur un sujet sans risque, contenu ancien) n'en est pas un. Liste vide [] s'il n'y en a aucun ; n'y ecris jamais "aucun signal".
Redige pour un humain : ne cite jamais les noms techniques des faits fournis (site_transparency, author_found, schema_types...), dis-le en francais courant.
Reponds UNIQUEMENT avec un objet JSON valide, en francais, de cette forme exacte :
{"page_purpose": "...", "inferred_query": "...", "ymyl": "none|low|high",
"scores": {"effort": 0, "originality": 0, "experience": 0, "expertise": 0, "authority": 0, "trust": 0, "needs_met": 0},
"pq_rating": "Medium", "lowest_signals": [], "evidence": ["element observe -> consequence"],
"fixes": [{"fix": "...", "why": "..."}], "verdict": "une phrase"}"""
SCORE_KEYS = ["effort", "originality", "experience", "expertise", "authority", "trust", "needs_met"]
RATINGS = ["Lowest", "Low", "Medium", "High", "Highest"]
LABELS = {"effort": "Effort", "originality": "Originalité", "experience": "Expérience", "expertise": "Expertise",
"authority": "Autorité", "trust": "Confiance", "needs_met": "Needs Met"}
def fetch(url, timeout=20):
req = urllib.request.Request(url, headers={"User-Agent": UA, "Accept-Language": "fr,en;q=0.8"})
with urllib.request.urlopen(req, timeout=timeout) as r:
ctype = r.headers.get("Content-Type", "")
raw = r.read(3_000_000)
charset = r.headers.get_content_charset() or "utf-8"
return r.geturl(), ctype, raw.decode(charset, "replace")
class PageParser(HTMLParser):
"""Extrait titre, metas, titres, liens, signaux de confiance et texte principal."""
SKIP = {"script", "style", "noscript", "svg", "nav", "header", "footer", "aside", "form", "iframe", "template"}
BLOCK = {"p", "li", "h1", "h2", "h3", "h4", "h5", "h6", "tr", "div", "section", "article", "blockquote", "br", "pre", "td", "dd", "dt"}
def __init__(self):
super().__init__(convert_charrefs=True)
self.title, self.meta, self.links, self.headings = "", {}, [], []
self.skip, self.main_depth, self.in_title, self.cur_h = 0, 0, False, None
self.all_text, self.main_text, self.jsonld, self.in_jsonld = [], [], [], False
self.author_hint = False
def handle_starttag(self, tag, attrs):
a = dict(attrs)
if tag == "title":
self.in_title = True
elif tag == "meta":
key = (a.get("name") or a.get("property") or "").lower()
if key:
self.meta[key] = a.get("content", "")
elif tag == "a" and a.get("href"):
self.links.append(a["href"])
if "author" in (a.get("rel") or "") or "/author" in a["href"] or "/auteur" in a["href"]:
self.author_hint = True
elif tag == "script" and "ld+json" in (a.get("type") or ""):
self.in_jsonld = True
if tag in self.SKIP:
self.skip += 1
if tag in ("main", "article"):
self.main_depth += 1
if tag in ("h1", "h2", "h3") and not self.skip:
self.cur_h = [tag, ""]
if tag in self.BLOCK:
self._push("\n")
cls = (a.get("class") or "") + " " + (a.get("itemprop") or "")
if re.search(r"author|byline|auteur", cls, re.I):
self.author_hint = True
def handle_endtag(self, tag):
if tag == "title":
self.in_title = False
if tag == "script":
self.in_jsonld = False
if tag in self.SKIP and self.skip:
self.skip -= 1
if tag in ("main", "article") and self.main_depth:
self.main_depth -= 1
if self.cur_h and tag == self.cur_h[0]:
if self.cur_h[1].strip():
self.headings.append(f"{tag.upper()}: {self.cur_h[1].strip()}")
self.cur_h = None
if tag in self.BLOCK:
self._push("\n")
def handle_data(self, data):
if self.in_title:
self.title += data
if self.in_jsonld:
self.jsonld.append(data)
return
if self.skip:
return
if self.cur_h:
self.cur_h[1] += data
self._push(data)
def _push(self, s):
self.all_text.append(s)
if self.main_depth:
self.main_text.append(s)
def text(self):
def clean(parts):
t = re.sub(r"[ \t\r\f\v]+", " ", "".join(parts))
return re.sub(r"\n\s*\n+", "\n", t).strip()
main, full = clean(self.main_text), clean(self.all_text)
return main if len(main) > 0.3 * len(full) and len(main) > 400 else full
def parse(url, body):
p = PageParser()
p.feed(body)
text = p.text()
jsonld = " ".join(p.jsonld)
dates = {k: v for k, v in p.meta.items() if "time" in k or "date" in k}
for m in re.finditer(r'"(datePublished|dateModified)"\s*:\s*"([^"]+)"', jsonld):
dates[m.group(1)] = m.group(2)
author = p.meta.get("author", "")
m = re.search(r'"author"\s*:\s*\{[^}]*"name"\s*:\s*"([^"]+)"', jsonld)
if m:
author = author or m.group(1)
host = urlparse(url).netloc
internal, external = set(), set()
for href in p.links:
full = urldefrag(urljoin(url, href))[0]
if not full.startswith("http"):
continue
(internal if urlparse(full).netloc == host else external).add(full)
return {
"url": url, "title": p.title.strip(), "description": p.meta.get("description", ""),
"headings": p.headings[:40], "text": text, "words": len(text.split()),
"author": author, "author_hint": p.author_hint, "dates": dates,
"schema_types": sorted(set(re.findall(r'"@type"\s*:\s*"([^"]+)"', jsonld)))[:10],
"internal": internal, "external": len(external),
"robots": p.meta.get("robots", ""),
}
def sitemap_urls(root, limit):
urls, todo, seen = [], [urljoin(root, "/sitemap.xml"), urljoin(root, "/sitemap_index.xml")], set()
try:
_, _, robots = fetch(urljoin(root, "/robots.txt"), 10)
todo = re.findall(r"(?im)^sitemap:\s*(\S+)", robots) + todo
except Exception:
pass
while todo and len(urls) < 5000 and len(seen) < 12:
sm = todo.pop(0)
if sm in seen:
continue
seen.add(sm)
try:
_, _, body = fetch(sm, 15)
tree = ET.fromstring(body.encode("utf-8"))
except Exception:
continue
for loc in tree.iter():
if loc.tag.endswith("loc") and loc.text:
u = loc.text.strip()
(todo if u.endswith(".xml") or "sitemap" in u.split("/")[-1] else urls).append(u)
return urls
def norm(url):
p = urlparse(url)
return p._replace(path=p.path or "/", fragment="").geturl()
def crawl(start, limit):
"""Pages a noter : sitemap d'abord, sinon les liens internes depuis l'accueil."""
host = urlparse(start).netloc
found = [u for u in dict.fromkeys(sitemap_urls(start, limit)) if urlparse(u).netloc == host]
step = max(1, len(found) // (limit * 2))
queue = found[::step] or [start]
if found:
print(f" sitemap : {len(found)} adresses, echantillon reparti de {len(queue)}")
seen, pages = set(), []
while queue and len(pages) < limit:
url = norm(queue.pop(0))
if url in seen or SKIP_EXT.search(urlparse(url).path):
continue
seen.add(url)
try:
final, ctype, body = fetch(url)
except Exception as e:
print(f" ! {url} : {e}")
continue
if "html" not in ctype:
continue
final = norm(final)
if final != url and final in seen:
continue
seen.add(final)
page = parse(final, body)
if "noindex" in page["robots"].lower() or page["words"] < 80:
print(f" - ignoree (noindex ou presque vide) : {final}")
else:
pages.append(page)
print(f" + {final} ({page['words']} mots)")
queue += [u for u in sorted(page["internal"]) if u not in seen and "?" not in u]
time.sleep(0.5)
return pages
def site_signals(start):
"""Transparence du site : pages a propos, contact, mentions legales."""
try:
_, _, body = fetch(start)
except Exception:
return {}
low = body.lower()
return {
"a_propos": bool(re.search(r"a-propos|about|qui-sommes|notre-histoire|equipe", low)),
"contact": "contact" in low,
"mentions_legales": bool(re.search(r"mentions-legales|mentions l[eé]gales|legal|imprint", low)),
"cgv_confidentialite": bool(re.search(r"cgv|confidentialit|privacy", low)),
}
def ask_ai(cfg, page, site, query, max_chars):
text = page["text"][:max_chars]
yes = lambda k: "lien trouve sur l'accueil" if site.get(k) else "pas de lien sur l'accueil"
facts = [
f"Adresse : {page['url']}", f"Titre : {page['title']}", f"Meta description : {page['description'] or 'absente'}",
"Auteur : " + (page["author"] or ("indice d'auteur dans la page" if page["author_hint"] else "aucun auteur identifie")),
"Dates : " + (", ".join(f"{k} {v}" for k, v in page["dates"].items()) or "aucune date trouvee"),
"Donnees structurees : " + (", ".join(page["schema_types"]) or "aucune"),
f"Longueur : {page['words']} mots, {page['external']} liens sortants",
f"Page A propos : {yes('a_propos')} ; page Contact : {yes('contact')} ; mentions legales : {yes('mentions_legales')}",
"Requete visee : " + (query or "a deduire"),
]
user = ("Faits extraits automatiquement (fiables) :\n" + "\n".join(facts)
+ "\n\nStructure :\n" + "\n".join(page["headings"])
+ "\n\nContenu principal (tronque si long) :\n<<<\n" + text + "\n>>>")
body = {"model": cfg["model"], "temperature": 0.2, "max_tokens": 1400,
"messages": [{"role": "system", "content": GRID}, {"role": "user", "content": user}]}
if "nvidia" in cfg["base"]:
body["chat_template_kwargs"] = {"enable_thinking": False}
for attempt in range(3):
req = urllib.request.Request(cfg["base"].rstrip("/") + "/chat/completions", data=json.dumps(body).encode(),
headers={"Authorization": "Bearer " + cfg["key"], "Content-Type": "application/json"})
try:
with urllib.request.urlopen(req, timeout=120) as r:
out = json.loads(r.read())["choices"][0]["message"]["content"]
return coherent(parse_json(out))
except urllib.error.HTTPError as e:
msg = e.read().decode("utf-8", "replace")[:200]
if e.code in (429, 500, 502, 503) and attempt < 2:
time.sleep(8 * (attempt + 1))
continue
raise RuntimeError(f"API {e.code} : {msg}")
except (ValueError, KeyError) as e:
if attempt < 2:
continue
raise RuntimeError(f"reponse illisible : {e}")
def parse_json(out):
out = re.sub(r"<think>.*?</think>", "", out, flags=re.S)
m = re.search(r"\{.*\}", out, re.S)
if not m:
raise ValueError("pas de JSON")
data = json.loads(m.group(0))
scores = data.get("scores", {})
data["scores"] = {k: max(0, min(10, int(round(float(scores.get(k, 0) or 0))))) for k in SCORE_KEYS}
data["lowest_signals"] = [s for s in (data.get("lowest_signals") or [])
if str(s).strip() and not re.match(r"\s*(aucun|none|pas de)", str(s), re.I)]
if data.get("pq_rating") not in RATINGS:
data["pq_rating"] = "Medium"
return data
def coherent(data):
"""Applique les regles du guide que les modeles oublient : la note n'est pas une moyenne."""
s, rating = data["scores"], data["pq_rating"]
avg = sum(s.values()) / len(s)
cap, why = rating, ""
ymyl = data.get("ymyl")
if data["lowest_signals"] and ymyl == "high":
cap, why = "Lowest", "signal Lowest sur un sujet YMYL"
elif data["lowest_signals"]:
cap, why = "Low", "signal Lowest relevé"
elif ymyl == "high" and s["trust"] < 4:
cap, why = "Low", "sujet YMYL avec une confiance trop faible"
elif ymyl == "low" and s["trust"] <= 2:
cap, why = "Low", "confiance trop faible pour le sujet"
elif avg < 3:
cap, why = "Low", "contenu trop faible sur l'ensemble des critères"
if RATINGS.index(cap) < RATINGS.index(rating):
data["pq_rating"] = cap
data["verdict"] = f"{data.get('verdict', '')} (Note ramenée à {cap} : {why}.)".strip()
return data
def color(v):
return "#e24b4a" if v < 4 else "#ef9f27" if v < 7 else "#1d9e75"
def write_reports(results, out):
order = {r: i for i, r in enumerate(RATINGS)}
results.sort(key=lambda r: (order[r["ai"]["pq_rating"]], sum(r["ai"]["scores"].values())))
with open(out + ".csv", "w", newline="", encoding="utf-8-sig") as f:
w = csv.writer(f, delimiter=";")
w.writerow(["url", "note", "ymyl", "requete"] + SCORE_KEYS + ["verdict", "correction 1", "correction 2", "correction 3"])
for r in results:
a = r["ai"]
fixes = [x.get("fix", "") if isinstance(x, dict) else str(x) for x in a.get("fixes", [])][:3]
w.writerow([r["url"], a["pq_rating"], a.get("ymyl", ""), a.get("inferred_query", "")]
+ [a["scores"][k] for k in SCORE_KEYS] + [a.get("verdict", "")] + fixes)
e = html.escape
cards = []
for r in results:
a = r["ai"]
bars = "".join(f'<div class="c"><span>{LABELS[k]}</span><b style="color:{color(v)}">{v}/10</b>'
f'<i><u style="width:{v * 10}%;background:{color(v)}"></u></i></div>' for k, v in a["scores"].items())
fixes = "".join(f'<li><b>{e(x.get("fix", ""))}</b> {e(x.get("why", ""))}</li>' if isinstance(x, dict)
else f"<li>{e(str(x))}</li>" for x in a.get("fixes", []))
ev = "".join(f"<li>{e(str(x))}</li>" for x in a.get("evidence", []))
low = ", ".join(map(str, a.get("lowest_signals") or []))
cards.append(f"""<section><div class="top"><a href="{e(r['url'])}">{e(r['url'])}</a><em class="r{RATINGS.index(a['pq_rating'])}">{a['pq_rating']}</em></div>
<p class="meta">YMYL : {e(str(a.get('ymyl', '?')))} · requête : {e(str(a.get('inferred_query', '')))} · {r['words']} mots</p>
<p>{e(str(a.get('verdict', '')))}</p>{f'<p class="warn">Signaux Lowest : {e(low)}</p>' if low else ''}
<div class="bars">{bars}</div><h3>À corriger</h3><ol>{fixes}</ol><details><summary>Preuves relevées</summary><ul>{ev}</ul></details></section>""")
dist = {k: sum(1 for r in results if r["ai"]["pq_rating"] == k) for k in RATINGS}
summary = " · ".join(f"{k} : {v}" for k, v in dist.items() if v)
page = f"""<!doctype html><html lang="fr"><meta charset="utf-8"><meta name="viewport" content="width=device-width">
<title>Rapport Quality Rater</title><style>
body{{font:15px/1.6 system-ui,sans-serif;background:#14161a;color:#e8e9ec;max-width:900px;margin:auto;padding:24px}}
a{{color:#f0c46a;word-break:break-all}}h1{{font-size:26px}}h3{{font-size:15px;margin:14px 0 4px}}
section{{background:#1b1e24;border:1px solid #30353e;border-radius:14px;padding:18px 22px;margin:16px 0}}
.top{{display:flex;justify-content:space-between;gap:12px;align-items:center}}.meta{{color:#8b909a;font-size:13px;margin:4px 0}}
em{{font-style:normal;font-weight:700;padding:4px 10px;border-radius:8px;white-space:nowrap}}
.r0,.r1{{background:#4a1b1b;color:#f09595}}.r2{{background:#4a3410;color:#f5b544}}.r3,.r4{{background:#0f3d2e;color:#5dcaa5}}
.bars{{display:grid;grid-template-columns:repeat(auto-fit,minmax(240px,1fr));gap:6px 22px;margin-top:10px}}
.c{{display:grid;grid-template-columns:1fr auto;font-size:13px}}.c i{{grid-column:1/3;height:7px;background:#2a2e36;border-radius:4px;overflow:hidden}}
.c u{{display:block;height:100%}}.warn{{color:#f09595}}li{{margin:3px 0}}summary{{cursor:pointer;color:#8b909a}}
</style><h1>Rapport Quality Rater</h1><p class="meta">{len(results)} pages notées · {summary} · généré par rater.py</p>
{''.join(cards)}</html>"""
with open(out + ".html", "w", encoding="utf-8") as f:
f.write(page)
def main():
ap = argparse.ArgumentParser(description="Notez vos pages comme les Quality Raters de Google.")
ap.add_argument("url", nargs="+", help="site a crawler, ou une ou plusieurs pages avec --one")
ap.add_argument("--ai", default="nemotron", choices=list(PROVIDERS) + ["custom"], help="fournisseur (defaut : nemotron)")
ap.add_argument("--model", help="modele a utiliser a la place du modele par defaut")
ap.add_argument("--base-url", help="API compatible OpenAI (avec --ai custom)")
ap.add_argument("--key", help="cle d'API (sinon variable d'environnement)")
ap.add_argument("--pages", type=int, default=10, help="nombre de pages a noter (defaut : 10)")
ap.add_argument("--one", action="store_true", help="noter seulement les URL donnees, sans crawl")
ap.add_argument("--query", help="requete cible (sinon deduite pour chaque page)")
ap.add_argument("--chars", type=int, default=12000, help="caracteres de contenu envoyes par page")
ap.add_argument("--pause", type=float, default=3, help="secondes entre deux appels (cles gratuites)")
ap.add_argument("--out", default="rater-report")
a = ap.parse_args()
base, model, env = PROVIDERS.get(a.ai, (a.base_url, a.model, "RATER_API_KEY"))
cfg = {"base": a.base_url or base, "model": a.model or model, "key": a.key or os.environ.get(env) or os.environ.get("RATER_API_KEY")}
if not cfg["base"] or not cfg["model"]:
sys.exit("Avec --ai custom, donnez --base-url et --model.")
if not cfg["key"]:
sys.exit(f"Cle manquante : definissez {env} ou passez --key.")
urls = [u if u.startswith("http") else "https://" + u for u in a.url]
url = urls[0]
print(f"Crawl de {url} ...")
if a.one:
pages = []
for u in urls:
try:
final, _, body = fetch(u)
pages.append(parse(final, body))
except Exception as e:
print(f" ! {u} : {e}")
else:
pages = crawl(url, a.pages)
if not pages:
sys.exit("Aucune page exploitable.")
site = site_signals(f"{urlparse(url).scheme}://{urlparse(url).netloc}/")
print(f"\nNotation de {len(pages)} pages avec {cfg['model']} ...")
results = []
for i, page in enumerate(pages, 1):
try:
ai = ask_ai(cfg, page, site, a.query, a.chars)
except Exception as e:
print(f" [{i}/{len(pages)}] echec {page['url']} : {e}")
continue
results.append({"url": page["url"], "words": page["words"], "ai": ai})
s = ai["scores"]
print(f" [{i}/{len(pages)}] {ai['pq_rating']:<8} trust {s['trust']}/10 needs met {s['needs_met']}/10 {page['url']}")
if i < len(pages):
time.sleep(a.pause)
if not results:
sys.exit("Aucune page notee.")
write_reports(results, a.out)
print(f"\nRapport : {os.path.abspath(a.out + '.html')}\nTableur : {os.path.abspath(a.out + '.csv')}")
if __name__ == "__main__":
main()
En ligne
Pages : 1
Accueil › Agents et automatisation IA › Le guide des Quality Raters de Google transformé en script gratuit !
Haut